Traducción asistida por máquina
2hives es independiente y no está afiliada, respaldada ni vinculada a Monroe Products ni a The Monroe Institute. Los nombres de productos que aparecen en esta nota son marcas de sus propietarios y se usan solo para referirse con exactitud a obras publicadas. Las mediciones describen únicamente la estructura acústica; no se reproduce ningún audio, guion ni texto de folleto. Nada de lo que aparece aquí es una afirmación de salud.
Programas de pulsos binaurales por capas: estructura medida en un conjunto de referencia y un método de síntesis reproducible
Nota de investigación de 2hives · 10 de octubre de 2026 · Versión 1.0
Resumen
Los programas comerciales de pulsos binaurales se describen con lenguaje de marketing o de patente, pero su construcción acústica rara vez se mide. Analizamos un programa guiado de pulsos binaurales, publicado comercialmente y de varios volúmenes, con un método de análisis abierto. El método usa ventanas de Hann de 16 s, desplazadas cada 10 s, a 11,025 kHz, lo que da una resolución de 0,0625 Hz. Los picos de tono deben superar en al menos 18 dB una mediana local y se refinan por interpolación parabólica. Después, los picos se emparejan entre los dos oídos y se enlazan en el tiempo, y en paralelo se miden el espectro del ruido, la coherencia interaural y la actividad del habla.
Seguimos 620 componentes binaurales sostenidos (≥ 40 s). Los hallazgos principales son:
- Fondos por capas. El fondo es una pila de pares de senoides, normalmente 2–3 a la vez en los volúmenes posteriores y hasta 13 en una pista.
- Orden portadora–pulso. El pulso sube con la portadora (ρ de Spearman = 0,53): los pulsos por debajo de 1 Hz van sobre portadoras de ~50 Hz, los de 1,5 Hz sobre 100 Hz, los de ~4 Hz sobre 200–400 Hz y los de 7–10 Hz sobre 500–800 Hz.
- Gradiente de nivel. El nivel de cada componente baja 5,9 dB por octava de portadora.
- Pulso dominante. El 45 % de los componentes del cuerpo principal pulsa a 3,5–4,25 Hz.
- Pulsos constantes. Los pulsos se mantienen dentro de ±0,01 Hz/min. La excepción es el primer volumen, donde ambas portadoras derivan hacia abajo.
- Ruido. El ruido cae a −7,5 dB/octava. Es casi mono por debajo de 4 kHz en el primer volumen y totalmente independiente entre los oídos en los volúmenes II, V y VI, donde lleva un ciclo de nivel y brillo de 10 s.
- Bloque de despertar. Treinta y cinco de las 36 pistas terminan con un bloque más fuerte de pulsos en los rangos beta y gamma.
A partir de estas medidas construimos un motor de síntesis solo del fondo y lo pusimos a prueba volviendo a analizar, con la misma herramienta, renders de prueba de cuatro pistas de referencia. Con las formas de ruido medidas se recuperaron 55 de 64 componentes sostenidos, con errores medianos de pulso ≤ 0,02 Hz y un error mediano de tiempo nulo. La pendiente del ruido coincidió con un margen de 0,7 dB/octava. La coherencia interaural limitada en banda del primer volumen solo se reprodujo en parte (MSC 0,74 frente a 0,89).
Relacionamos los hallazgos con las patentes de Monroe y con la evidencia dispar sobre el arrastre por pulsos binaurales. No se hace ninguna afirmación terapéutica.
1. Introducción
1.1 Los pulsos binaurales y la respuesta de seguimiento de frecuencia
Cuando dos tonos de frecuencia ligeramente distinta, f<sub>L</sub> y f<sub>R</sub>, llegan por separado a cada oído, quien escucha percibe una fluctuación a |f<sub>R</sub> − f<sub>L</sub>|. Las ondas nunca se mezclan acústicamente, así que este pulso binaural se genera de forma central, muy probablemente en el complejo olivar superior (Chaieb et al., 2015; Orozco Perez et al., 2020).
Oster (1973) resumió la psicofísica clásica:
- El pulso es más claro con portadoras cercanas a 440 Hz y se desvanece hacia los 1000 Hz (otros investigadores lo sitúan hasta ~1500 Hz).
- Por debajo de ~90 Hz el pulso se confunde fácilmente con los propios tonos.
- Resiste grandes diferencias de nivel entre los oídos.
- Sigue siendo audible como modulación de un ruido enmascarador.
Un pulso monoaural es distinto: dos tonos en el mismo oído se mezclan físicamente y producen una modulación de amplitud.
El tronco encefálico auditivo se sincroniza en fase con el sonido periódico. Esto produce una respuesta de seguimiento de frecuencia (FFR) registrable en el cuero cabelludo a las frecuencias del estímulo. A la frecuencia del pulso, la corteza puede mostrar una respuesta auditiva de estado estable (ASSR). Orozco Perez et al. (2020) registraron ambas en los mismos participantes. El uso comercial se apoya en una hipótesis de arrastre más fuerte: que un pulso sostenido en una banda de EEG convencional desplaza los ritmos cerebrales en curso y, con ellos, el estado mental. La evidencia sobre esa hipótesis es inconsistente (§7.2).
1.2 Historia y objetivos
R. A. Monroe patentó entre 1975 y 1994 métodos de audio para inducir el sueño y "estados de conciencia". La formación "Gateway" de The Monroe Institute y sus grabaciones para estudio en casa usaban el proceso de pulsos binaurales resultante. Atwater (1997) describió ese proceso, y una evaluación del Ejército de EE. UU. de 1983, publicada por la CIA, lo analizó (McDonnell, 1983).
Ninguna de las dos fuentes da portadoras, pulsos, niveles ni parámetros de ruido. Hasta donde sabemos, nadie los ha publicado para las grabaciones distribuidas. Esta nota tiene tres objetivos:
- Medir el fondo de estímulos de las grabaciones con un método abierto y reproducible.
- Especificar un motor que sintetice fondos con la misma estructura medible.
- Validar el motor volviendo a medir su salida con la misma herramienta.
2. Descripciones técnicas previas
US 3,884,218 (1975) es anterior a los pulsos binaurales. Reivindica un "familiar, repetitive, pleasing sound" (sonido familiar, repetitivo y agradable) modulado en amplitud por una señal con forma de EEG de sueño y reproducido por encima del ruido ambiente. Entre los sonidos candidatos están la lluvia, el viento, las olas sobre una playa, la respiración y un zumbido de 500 Hz.
US 5,213,562 (1993) superpone una "replicated EEG waveform" (forma de onda de EEG replicada) sobre dos conjuntos de portadoras estéreo, de modo que aparece como frecuencias de pulso interaurales. Su ejemplo desarrollado usa portadoras de 100 Hz y 104 Hz (un pulso de 4 Hz). Admite "as many as 100 separate carrier pairs" (hasta 100 pares de portadoras independientes) y señala 275 Hz como la "most effective harmonic carrier" (portadora armónica más eficaz) para 4–5 Hz.
La misma patente define el Phased Pink Sound como "relative rotational shifting of pink sound from one stereo audio channel to another with cyclic changes in amplitude, frequency, and rate of panning" (desplazamiento rotacional relativo del sonido rosa de un canal de audio estéreo a otro, con cambios cíclicos de amplitud, frecuencia y velocidad de paneo). Reivindica que, usado al menos 10 dB por debajo de las señales de pulso, potencia la FFR hasta un 30 %. Su código fuente es un filtro peine barrido de forma sinusoidal sobre ruido, con retardos de 60–80 muestras y un ciclo de 8 s.
US 5,356,368 (1994) añade cuatro elementos:
- Un Septon. Tres pulsos binaurales y dos pulsos monoaurales por oído sobre una escalera de portadoras compartida. En el ejemplo, el oído izquierdo tiene 200, 204 y 208 Hz y el derecho 204, 208 y 212 Hz.
- Ruido con flanger. Un retardo de filtro peine barrido a "alrededor de 1/8 Hz", con una fase de barrido izquierda/derecha arbitraria.
- Grupos de señales apilados. Una secuencia de 90 min de grupos con desfases fijos (el grupo B 15 dB por debajo del A; ruido y voz 10–20 dB por debajo del grupo principal).
- Una secuencia de despertar. Señales en el rango beta o "una envolvente de 400 Hz/416 Hz" unos 5 min antes de despertar. La reivindicación 15 especifica señales theta–alfa seguidas de señales beta–gamma.
Atwater (1997) describe pulsos binaurales combinados con estimulación restringida, guía verbal, "pink sound" (sonido rosa) y sonidos naturales. Afirma que los estímulos eficaces son "complex brain-wave-like patterns rather than simple sine waves" (patrones complejos parecidos a ondas cerebrales y no simples ondas senoidales) (sus Figs. 1–2). Cita el límite de portadora de ~1000 Hz de Oster y la observación de que el ruido refuerza el pulso. No da frecuencias ni niveles.
McDonnell (1983) describe las frecuencias como "played at a virtually subliminal, marginally audible level" (reproducidas a un nivel prácticamente subliminal, apenas audible), a veces "rolled in together with other sounds such as sea surf" (mezcladas con otros sonidos como el oleaje del mar). Indica que el "pink and white noise" (ruido rosa y blanco) entra en una etapa posterior y que las etapas posteriores añaden "additional levels of sound" (niveles adicionales de sonido).
La tabla 1 recoge las afirmaciones de construcción que nuestros datos pueden poner a prueba.
Tabla 1. Afirmaciones de construcción comprobables.
| # | Afirmación | Fuente |
|---|---|---|
| C1 | Portadoras graves; ejemplo desarrollado de 100/104 Hz | US 5,213,562 |
| C2 | Varios pares de portadoras a la vez (pulso "complejo") | US 5,213,562; Atwater 1997 |
| C3 | Grupos de señales con desfases fijos de 10–20 dB | US 5,356,368 |
| C4 | Escalera Septon (3 pulsos binaurales + 2 monoaurales por oído) | US 5,356,368 |
| C5 | Ruido "en fase" cíclico entre oídos, ~8 s | US 5,213,562; 5,356,368 |
| C6 | Ruido ≥ 10 dB por debajo de las señales de pulso | US 5,213,562 |
| C7 | Sonido modulado en amplitud parecido al oleaje | US 3,884,218; McDonnell 1983 |
| C8 | Tonos a un nivel apenas audible | McDonnell 1983 |
| C9 | Bloque de despertar beta/gamma | US 5,356,368 |
3. Materiales y métodos
3.1 Material de referencia
El conjunto de referencia es un programa guiado publicado comercialmente, de varios volúmenes. Las pistas duran unos 27–46 minutos y combinan una guía hablada con un fondo continuo de tonos y ruido.
Aquí no se reproduce ningún audio, guion ni texto de folleto.
Las pistas se agruparon según las etiquetas de etapa del editor, asignadas a partir del título y el volumen: Stage A (5 pistas), Stage B (19; volumen 2–4 más la primera pista de volumen 5), Stage C (5), Stage D (6) y una pista introductoria Stage A. Estas etiquetas sirven solo como variables de agrupación.
3.2 Método de análisis
La herramienta de análisis usa las mismas primitivas de análisis que el motor también usa para verificar sus propios renders. Cada pista se decodifica dos veces con ffmpeg a estéreo en coma flotante: una a 11,025 kHz para los tonos y otra a 44,1 kHz para el ruido y la voz. El análisis usa ventanas de 16 s cada 10 s, unas 215 ventanas por pista. La tabla 2 recoge los parámetros.
Tabla 2. Parámetros del análisis.
| Etapa | Regla |
|---|---|
| Espectro de tonos | Una FFT con ventana de Hann por oído y por ventana (176 400 puntos); separación entre bins de 0,0625 Hz; 20–1500 Hz; amplitud corregida para que una senoide a escala completa marque 0 dBFS (pico) |
| Detección de picos | ≥ 18 dB por encima de una mediana móvil del espectro en dB sobre 5 Hz; picos separados ≥ 0,3 Hz; interpolación parabólica de tres puntos para la frecuencia por debajo del bin |
| Par binaural | Para cada tono izquierdo, del más fuerte al más débil: el tono derecho no usado más cercano con 0,25 ≤ |Δf| ≤ 45 Hz y diferencia de nivel ≤ 6 dB. Se descarta si el tono derecho también existe en el oído izquierdo (±0,25 Hz) |
| Monoaural / diótico | Tonos en el mismo oído separados 0,25–45 Hz y a menos de 10 dB; misma frecuencia en ambos oídos (±0,15 Hz) |
| Seguimiento de componentes | Una detección se une al componente abierto cuyas últimas frecuencias izquierda y derecha están a ±0,6 Hz y que se vio en los últimos 120 s. Los componentes necesitan ≥ 3 detecciones. Sostenido significa una duración ≥ 40 s. El deslizamiento es la pendiente por mínimos cuadrados en Hz/min para duraciones ≥ 60 s |
| Habla | Canal medio (L+R)/2, paso banda de fase cero de 300–3400 Hz; envolvente RMS de 50 ms. Hay habla cuando la diferencia entre los percentiles 90 y 20 es > 14 dB (modulación a ritmo silábico) y la potencia medio/lateral en la banda es > 6 dB |
| Ruido (ventanas sin habla) | PSD de Welch (8192 puntos) en seis octavas, 250 Hz–16 kHz; pendiente ajustada entre 500 Hz y 16 kHz (dB/octava). Coherencia interaural de magnitud al cuadrado (MSC, 4096 puntos, resolución de 10,8 Hz) promediada en 1–4 kHz y 4–10 kHz |
| Niveles | RMS por oído. Fondo = mediana de las ventanas sin habla; voz = mediana de las ventanas con habla |
La prueba de prominencia de 18 dB es relativa al suelo local, así que la detección depende del ruido circundante y no del nivel absoluto. Con unos 340 segmentos de Welch por ventana, la MSC de señales independientes tiene un suelo de sesgo de alrededor de 0,003 (Carter et al., 1973).
El informe del análisis agrega los 36 archivos. Los componentes que terminan más de 240 s antes del final de una pista forman el cuerpo principal (338 componentes). Los que empiezan en los últimos 300 s forman el bloque de despertar. Las bandas de pulso son:
| Banda | Rango (Hz) |
|---|---|
| sub-delta | < 0,5 |
| delta | 0,5–< 4 |
| theta | 4–< 8 |
| alfa | 8–< 13 |
| beta | 13–< 30 |
| gamma | ≥ 30 |
El pulso más frecuente, 4,0 Hz, está en el límite delta/theta, así que también damos los pulsos directamente.
Medidas complementarias. Los parámetros del ciclo de ruido de §4.7 proceden de un análisis de envolvente de pasajes sin habla hecho por el equipo de 2hives (10 de octubre de 2026). Se presentan tal como se recibieron.
3.3 Procedimiento de prueba de síntesis
Una herramienta de síntesis convierte el análisis de una referencia en una plantilla solo de fondo (sin voz):
- Pistas de tono. Cada componente sostenido se convierte en una pista de tono con los mismos tiempos de inicio y fin y las mismas frecuencias izquierda/derecha inicial y final, con deslizamiento lineal. Su nivel es el primer y el último valor si difieren en más de 3 dB; si no, la mediana. Los fundidos duran 8 s.
- Nivel de ruido. RMS del fondo menos la potencia de los tonos activos a mitad del programa.
- Carácter del ruido. El espectro del ruido se mide en la referencia con una herramienta de análisis (PSD de Welch de las ventanas sin habla, filtrada por mediana sobre ⅓ de octava para quitar los tonos, muestreada en puntos de ⅙ de octava). La correlación interaural y los ajustes del ciclo se fijan por volumen (tabla 9).
Las plantillas se renderizan sin normalización de sonoridad y después se analizan. Una herramienta de comparación empareja cada componente sostenido de la referencia con un componente del render de prueba que se solapa con él en el tiempo, con frecuencias iniciales izquierda y derecha a menos de 0,15 Hz. Informa de los errores de pulso, nivel y tiempo y de las métricas de ruido.
4. Resultados
4.1 Visión general
Tabla 3. Medianas por volumen (seis pistas cada uno).
| Volumen | Ventanas con habla | RMS del fondo (dBFS) | Componentes sostenidos / pista | Pendiente del ruido (dB/oct) | MSC 1–4 kHz | MSC 4–10 kHz |
|---|---|---|---|---|---|---|
| volumen 1 | 17% | −35,0 | 10 | −7,8 | 0,90 | 0,20 |
| volumen 2 | 26% | −31,5 | 12 | −6,1 | 0,003 | 0,004 |
| volumen 3 | 10% | −38,5 | 13,5 | −9,4 | 0,71 | 0,07 |
| volumen 4 | 11% | −41,0 | 19,5 | −7,2 | 0,48 | 0,07 |
| volumen 5 | 14% | −35,7 | 20,5 | −8,9 | 0,003 | 0,007 |
| volumen 6 | 10% | −33,6 | 19 | −6,4 | 0,004 | 0,014 |
| Todos | 14% | −34,5 | — | −7,5 | — | — |
Seguimos 620 componentes sostenidos. Su duración mediana fue de 136 s (percentil 90: 1146 s), y 96 duraron al menos 10 min.
4.2 Portadoras
Los centros de portadora ((f<sub>L</sub> + f<sub>R</sub>)/2) se agrupan en valores redondos (tabla 4). Todos están en ~1000 Hz o por debajo, el límite que da Oster (1973), y solo el 1 % se acerca a él. El par de 100/104 Hz de US 5,213,562 aparece exactamente y domina volumen 1.
Fuera de volumen 1, las frecuencias se repiten entre pistas con una diferencia de 0,01 Hz como mucho (p. ej., 495,00/505,00, 99,25/100,75 y 467,00/483,00 Hz). Esto apunta a una biblioteca fija de tonos generados digitalmente.
Tabla 4. Centros de portadora de los componentes sostenidos (intervalos de 25 Hz, los 12 primeros de 620).
| Centro (Hz) | n | Centro (Hz) | n |
|---|---|---|---|
| 500 | 78 | 200 | 35 |
| 600 | 67 | 250 | 19 |
| 100 | 65 | 475 | 19 |
| 50 | 55 | 800 | 16 |
| 400 | 52 | 275 | 15 |
| 300 | 46 | 350 | 12 |
4.3 Pulsos por etapa
Tabla 5. Pulsos del cuerpo principal por etapa (recuentos; sin el bloque de despertar).
| Etapa | n | sub-δ | δ | θ | α | β | γ | Pulsos más frecuentes, Hz (recuento) | Pares típicos (Hz) |
|---|---|---|---|---|---|---|---|---|---|
| Stage A | 27 | 0 | 14 | 7 | 4 | 2 | 0 | 3,75 (11), 4,0 (5) | 100/104, 298/302 |
| Stage B | 162 | 3 | 85 | 61 | 10 | 2 | 1 | 4,0 (42), 3,75 (25), 3,5 (23), 4,25 (14), 0,75 (8) | 50/50,5; 99/103; 401/397 |
| Stage C | 68 | 1 | 28 | 20 | 18 | 0 | 1 | 10,0 (17), 1,5 (14), 7,25 (12), 0,75 (8), 4,0 (8) | 595/605; 495/505; 99,25/100,75 |
| Stage D | 78 | 0 | 28 | 32 | 9 | 9 | 0 | 4,0 (22), 7,25 (11), 1,5 (10), 2,0 (8), 16,0 (6) | 248/252, 298/302, 38/36 |
| Todas | 338 | 4 | 158 | 120 | 41 | 13 | 2 | 4,0 (77), 3,75 (38), 10,0 (30), 1,5 (27), 7,25 (25) | — |
En el conjunto del cuerpo principal, 153 de 338 componentes (45 %) pulsan a 3,5–4,25 Hz. Las etapas se diferencian sobre todo en lo que se superpone alrededor de este núcleo (figs. 1–2):
- Stage A: un fondo de 3,75–4 Hz sobre portadoras de 100 Hz y 300 Hz, con breves componentes alfa y beta.
- Stage B: añade un grupo de 50 Hz con pulsos de 0,5–0,75 Hz.
- Stage C: añade una capa alfa (10 Hz sobre 495/505 y 595/605 Hz; 7,25 Hz sobre 504/511, 607/599 y 807/800 Hz) por encima de un par de 1,5 Hz en 99,25/100,75 Hz.
- Stage D: combina estas capas, añade un par de 2,12 Hz en 36/38 Hz y algunos componentes de 16 Hz.
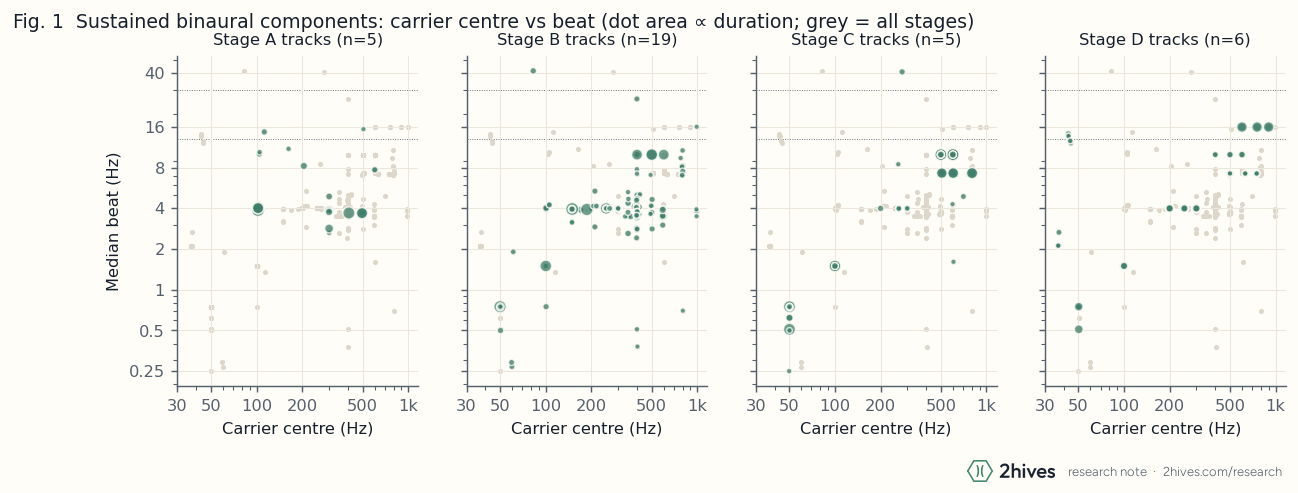
Figura 1. Centro de portadora frente al pulso mediano de los componentes del cuerpo principal por etapa (azul), comparado con todas las etapas (gris). El área de cada punto es proporcional a la duración; las líneas punteadas marcan los límites de banda.
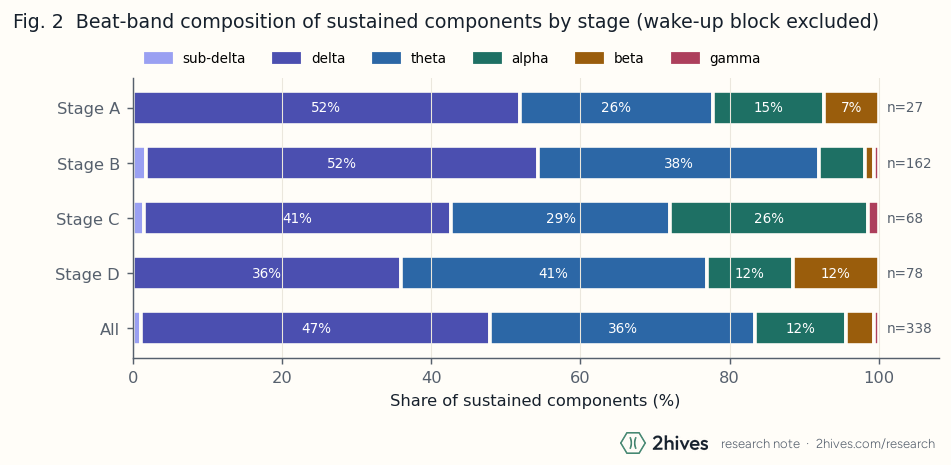
Figura 2. Proporción de bandas de pulso de los componentes del cuerpo principal por etapa.
4.4 Apilamiento: orden de portadoras, simultaneidad y nivel
Orden de portadoras. El pulso sube con la frecuencia portadora (ρ de Spearman = 0,53, n = 620; tabla 6). Cada pila coloca su pulso más lento sobre su portadora más grave. Por ejemplo, la pista de tipo Stage D de la fig. 3 combina:
| Portadora (Hz) | Pulso (Hz) |
|---|---|
| 50 | 0,5–0,75 |
| 100 | 1,5 |
| 200, 250, 300 | 4 |
| 400, 500, 600 | 10 |
Tabla 6. Pulso y nivel por banda de portadora (620 componentes sostenidos).
| Portadora (Hz) | n | Pulso mediano (Hz) | Pulso p10–p90 (Hz) | Nivel mediano (dBFS pico) |
|---|---|---|---|---|
| < 75 | 65 | 0,75 | 0,5–5,4 | −41,6 |
| 75–150 | 82 | 1,6 | 1,5–10,3 | −42,5 |
| 150–250 | 57 | 4,0 | 4,0–13,7 | −51,5 |
| 250–350 | 83 | 4,0 | 3,7–15,2 | −54,4 |
| 350–450 | 68 | 4,3 | 3,3–15,3 | −56,8 |
| 450–550 | 101 | 10,0 | 3,7–16,0 | −52,2 |
| 550–700 | 79 | 10,0 | 3,5–40,0 | −61,8 |
| 700–1100 | 69 | 7,3 | 3,3–30,6 | −82,8 |
Simultaneidad. Contamos los componentes sostenidos del cuerpo principal activos en el centro de cada ventana:
| Volumen | Mediana | Pct. 90 | Máx. | Proporción de ventanas con ≥ 2 |
|---|---|---|---|---|
| volumen 1 | 1 | 4 | 6 | 39% |
| volumen 2 | 1 | 2 | 3 | 12% |
| volumen 3 | 0 | 4 | 13 | 18% |
| volumen 4 | 1 | 3 | 11 | 40% |
| volumen 5 | 3 | 4 | 7 | 78% |
| volumen 6 | 2 | 5 | 8 | 59% |
Las medianas bajas de volumen 2–4 reflejan en parte tramos en los que ningún tono supera la prueba de prominencia de 18 dB bajo el habla o un ruido fuerte. Por tanto, el "pulso binaural complejo" (C2) se materializa como una pila de pares de senoides separados sobre portadoras relacionadas armónicamente, no como una única forma de onda no senoidal sobre una sola portadora.
Nivel. Los niveles de tono del cuerpo principal tienen unos percentiles 10/50/90 de −69,8/−53,5/−38,0 dBFS (pico). El nivel baja 5,9 dB por octava de portadora (n = 338; ρ = −0,69; fig. 4), así que los componentes de 50–100 Hz llevan la voz cantante. Dentro de una ventana, el par más fuerte supera al siguiente en una mediana de 2–7 dB, según el volumen.
Este gradiente continuo difiere de los grupos discretos de 10–20 dB de C3. El tono mediano está unos 16 dB por debajo del RMS del fondo en potencia de banda ancha, lo que encaja con "apenas audible" en términos relativos (C8). Sin embargo, significa que el ruido domina el fondo, lo contrario de C6.
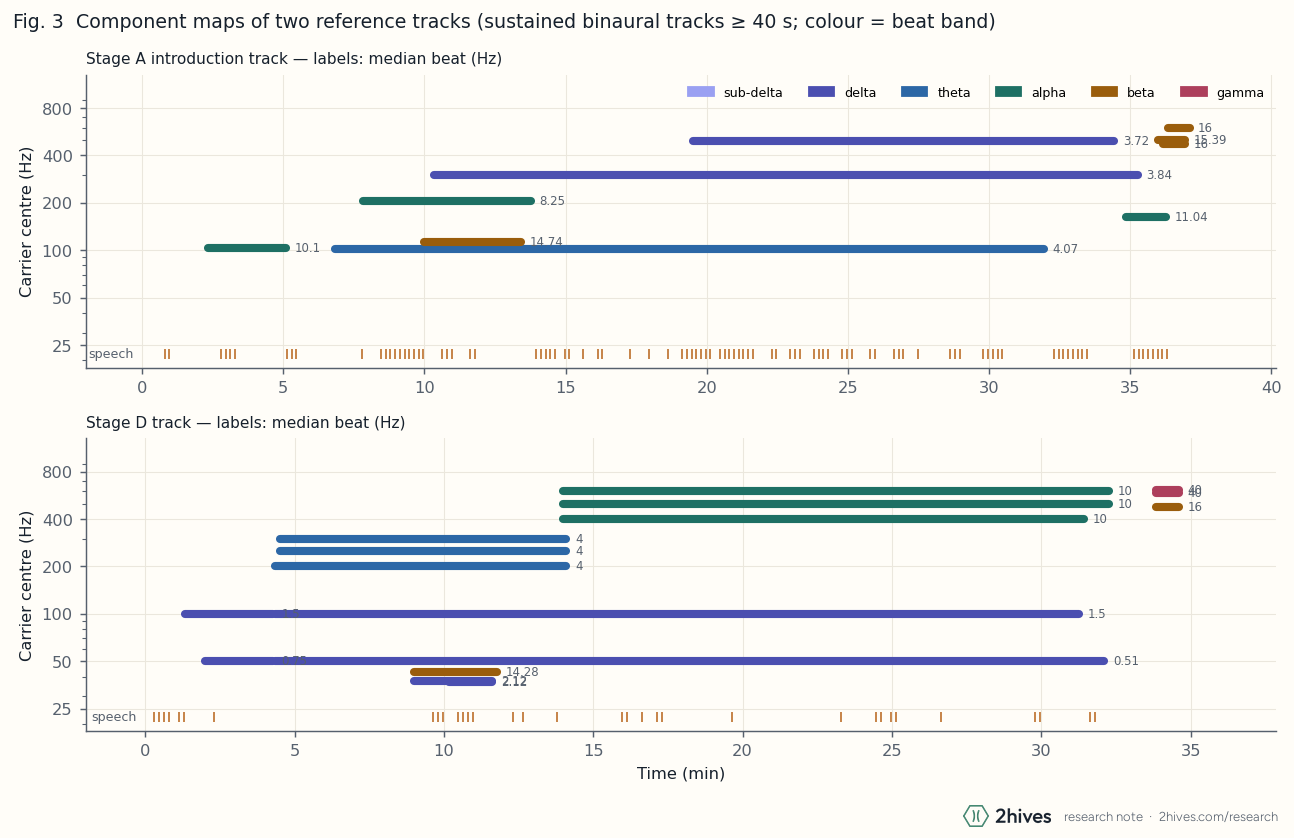
Figura 3. Mapas de componentes de una pista de tipo Stage A (arriba) y otra de tipo Stage D (abajo). Las barras marcan los componentes sostenidos en su centro de portadora, coloreadas por banda y etiquetadas con el pulso mediano. Las marcas señalan las ventanas con habla.
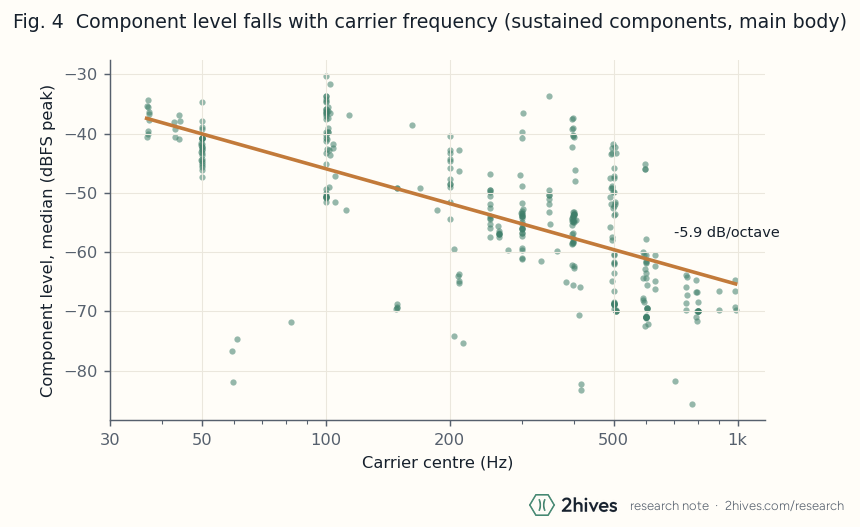
Figura 4. Nivel de los componentes frente al centro de portadora (cuerpo principal) con un ajuste por mínimos cuadrados en frecuencia logarítmica.
4.5 Orientación entre oídos y deslizamientos
Orientación. La portadora más aguda está en el oído derecho en 356 de 620 componentes (57,4 %; p binomial = 0,0003, que exagera la evidencia porque los componentes no son independientes). El mismo par aparece a menudo en ambas orientaciones dentro de una pista; por ejemplo, 99,25/100,75 y 100,75/99,25 Hz aparecen 13 veces cada uno.
Deslizamientos. Los pulsos se mantienen casi constantes. En los 155 componentes que duran al menos 5 min, los percentiles del deslizamiento del pulso son:
| Percentil | Deslizamiento del pulso (Hz/min) |
|---|---|
| 5 | −0,011 |
| 50 | 0,000 |
| 95 | +0,004 |
volumen 1 es la excepción. Las dos portadoras de sus componentes largos de 100/104 Hz y 298/302 Hz bajan 0,01–0,04 Hz/min, y el pulso baja alrededor de 0,01 Hz/min. Por ejemplo, 4,08 → 3,87 Hz en 25 min (100,27/104,35 → 99,84/103,71 Hz) y 4,10 → 3,86 Hz en 29 min. El equipo de 2hives midió de forma independiente 4,13 → 3,89 Hz en ~25 min.
Las dos portadoras bajan en proporciones distintas (−0,43 % y −0,61 %), así que la deriva no es un error de velocidad de reproducción. Puede tratarse de un barrido deliberado o de osciladores analógicos libres; los datos no permiten distinguirlos. Las trayectorias de nivel son igual de planas: la pendiente mediana es de −0,015 dB/min (percentiles 10–90: de −0,40 a +0,14).
4.6 Estructura monoaural y diótica
En 6334 ventanas sin habla no se encontró ninguna escalera Septon estricta (C4). Buscamos un tono izquierdo f, un tono compartido f + d y un tono derecho f + 2d, con d igual al pulso binaural. Varios grupos relacionados sí mezclan pulsos binaurales y monoaurales:
- Grupo de 50 Hz (volúmenes 2, 4–6). El oído izquierdo lleva 49,75 + 50,0 Hz y el derecho 50,0 + 50,5 Hz. Esto da pulsos binaurales de 0,5–0,75 Hz y pulsos monoaurales de 0,25–0,5 Hz, con 50,0 Hz diótico. El seguimiento a veces intercambia parejas dentro de este grupo, así que los aparentes "deslizamientos" de 0,75 → 0,25 Hz son aquí cambios de emparejamiento, no barridos.
- Par de 36/38 Hz (volumen 6). El oído izquierdo lleva 37,84 + 38,38 Hz y el derecho 35,72 + 36,26 Hz, lo que da un pulso binaural de 2,12 Hz y un pulso monoaural de 0,54 Hz en cada oído.
- Dobletes de despertar. El oído izquierdo lleva 568 + 592 Hz y el derecho 608 + 632 Hz, lo que da dos pulsos binaurales de 40 Hz sobre un pulso monoaural de 24 Hz en cada oído (§4.9).
Los tonos dióticos cercanos a 60, 120 y 180 Hz en los volúmenes 1, 3 y 4 son muy probablemente zumbido de red de la producción, no contenido diseñado.
4.7 Ruido: espectro, coherencia y el ciclo en fase
Espectro. El ruido sin habla cae con una mediana de −7,5 dB/octava (500 Hz–16 kHz). Es más pronunciado que el rosa (−3 dB/octava) y cercano al marrón (−6 dB/octava), así que el "sonido rosa" de las patentes debe entenderse en sentido amplio. Los volúmenes decorrelacionados tienen 8–12 dB menos de energía en 0,5–4 kHz, respecto a la octava de 250–500 Hz, que volumen 1 (fig. 5).
Coherencia. Los volúmenes se reparten en tres regímenes:
- volumen 1: casi mono y estable. La MSC es de unos 0,89 en 1–4 kHz y 0,18 en 4–10 kHz, así que los oídos comparten casi todo el ruido por debajo de ~4 kHz.
- Volúmenes 2, 5 y 6: independiente. La MSC es de 0,003–0,014, el suelo del estimador, así que cada oído recibe ruido independiente.
- Volúmenes 3 y 4: mixto. Las medianas por pista van de 0,003 a 0,93.
Ciclo. A partir de volumen 2, el ruido lleva un ciclo de 10,0 s (medidas complementarias; tabla 7).
Tabla 7. Variantes de modulación del ruido.
| Variante | Dónde | Oscilación de nivel por oído | Fase interaural | Efecto espectral |
|---|---|---|---|---|
| Estable | volumen 1 | ninguna | — | ninguno |
| Oleada | Introducción Stage B (volumen 2) | ambos oídos a la vez, hasta ≈ 10 dB p-p en 1,5–8 kHz | ≈ 0° | aclarado parecido al oleaje |
| Rotación | Pistas de tipo Stage C/Stage D | ±0,8 dB, sinusoidal | oído derecho ≈ 90° adelantado | centroide de 1–10 kHz ±235 Hz |
La variante de rotación coincide con el sonido rosa en fase de las patentes (C5): una rotación de nivel en cuadratura entre los oídos con un barrido espectral, como produciría un filtro peine barrido. Su periodo de 10,0 s es más largo que los 8 s y el "alrededor de 1/8 Hz" de las patentes. La variante de oleada coincide con el sonido modulado parecido al oleaje de US 3,884,218 y McDonnell (1983) (C7).
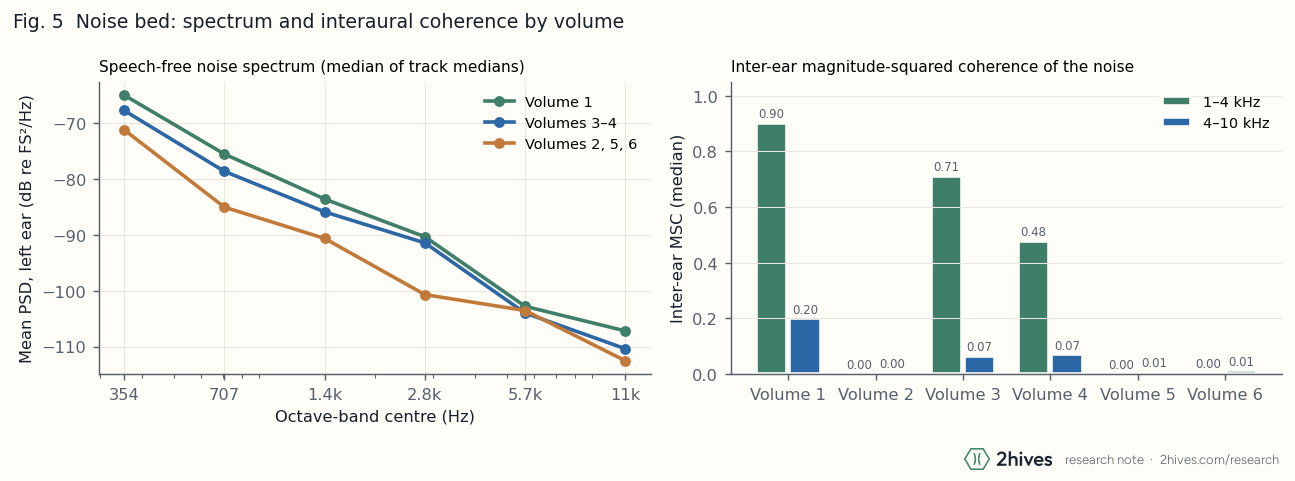
Figura 5. Izquierda: PSD del ruido por bandas de octava (oído izquierdo, sin habla) para tres grupos de volúmenes. Derecha: MSC interaural mediana por volumen; ≈ 0,003 es el suelo para señales independientes.
4.8 La voz respecto al fondo
En las 31 pistas con habla, las ventanas con habla son una mediana de 3,8 dB más fuertes que las ventanas sin habla (percentiles 10–90: 1,5–10,8 dB). La cifra baja de forma constante a lo largo de la serie. El nivel implícito de la voz sola respecto al fondo, obtenido restando la potencia del fondo, baja con ella:
| Volumen | Habla − fondo (dB) | Voz implícita respecto al fondo (dB) |
|---|---|---|
| volumen 1 | 10,1 | +9,6 |
| volumen 3 | 7,0 | +6,0 |
| volumen 4 | 6,1 | +4,8 |
| volumen 2 | 3,4 | +0,8 |
| volumen 5 | 2,8 | −0,4 |
| volumen 6 | 1,5 | −4,0 |
La guía está claramente por delante del fondo en el primer volumen y al nivel de la potencia de banda ancha del fondo, o por debajo, en el último.
4.9 Firma de despertar
En 35 de las 36 pistas empiezan componentes nuevos en los últimos 300 s, una mediana de 2,2 min antes del final (rango 0,8–4,8 min). De estas pistas:
- 33 contienen pulsos beta, normalmente de 15–16 Hz (77 componentes).
- 20 contienen pulsos gamma.
- 19 contienen pulsos de 30–40 Hz, casi siempre de exactamente 40 Hz (25 componentes).
El componente de despertar más fuerte de cada pista tiene un nivel mediano de −33,8 dBFS (percentiles 10–90: de −45,7 a −24,0), por encima del percentil 90 del cuerpo principal, −38,0 dBFS. Estos componentes pueden subir unos 20 dB en menos de un minuto.
Entre las pilas típicas están 467/483 Hz (16 Hz) con 568/608 y 592/632 Hz (40 Hz), y pares duplicados a la octava como 491,6/506,9 Hz (15,3 Hz) con 983,2/1013,7 Hz (30,5 Hz). El orden theta/alfa y después beta/gamma de la reivindicación 15 de US 5,356,368 aparece en varias pistas (C9).
4.10 Afirmaciones previas frente a lo medido
Tabla 8. Estado de las afirmaciones de la tabla 1.
| # | Afirmación | Hallazgo |
|---|---|---|
| C1 | Portadoras graves; 100/104 Hz | Confirmada: 100/104 Hz dominante en volumen 1; todas las portadoras ≤ ~1 kHz |
| C2 | Varios pares a la vez | Confirmada: mediana de 2–3 en los volúmenes posteriores, hasta 13; pilas ordenadas por portadora |
| C3 | Desfases fijos de grupo de 10–20 dB | No tal como se describe: gradiente continuo de −5,9 dB/octava |
| C4 | Escalera Septon | No encontrada: existen grupos relacionados de pulsos binaurales + monoaurales |
| C5 | Ruido en fase, ~8 s | Confirmada en la forma: rotación en cuadratura de 10,0 s con barrido espectral |
| C6 | Ruido ≥ 10 dB por debajo de los tonos | Al revés: el ruido domina la potencia del fondo |
| C7 | Modulación parecida al oleaje | Confirmada: oleada en fase de ~10 dB en la introducción Stage B |
| C8 | Tonos apenas audibles | Coherente (en términos relativos): tono mediano ≈ 16 dB por debajo del RMS del fondo |
| C9 | Despertar beta/gamma | Confirmada: 35/36 pistas, más fuerte que el cuerpo |
5. Método de síntesis
El motor de 2hives renderiza un programa a partir de una plantilla JSON y un guion. La voz se sintetiza por separado y se mezcla a −22 dBFS de RMS de habla activa. Aquí solo se describe el fondo.
Línea de tiempo. Una plantilla es una lista de fases. Cada fase tiene una duración fija (introducción, regreso) o un peso para repartirse el tiempo restante, de modo que un programa se alarga sin mover sus secciones fijas. Las líneas del guion conservan su desfase dentro de las fases fijas y su posición relativa dentro de las que se alargan.
Las fases contiguas se unen con fundidos cruzados complementarios de coseno elevado cuyas ganancias suman 1, y el programa tiene fundidos de 8 s en cada extremo. Un par compartido por fases contiguas es un único oscilador, así que atraviesa el límite sin reinicio de fase.
Tonos. Dos formas cubren todo lo medido en §4:
- Pares de fase: tripletes (f<sub>L</sub>, f<sub>R</sub>, nivel) asociados a las fases.
- Pistas: pares con sus propios tiempos de inicio y fin, deslizamientos lineales de frecuencia, rampas de nivel lineales en dB y fundidos de coseno elevado.
Juntas cubren pilas sobre cualquier portadora, ambas orientaciones entre oídos, pulsos por debajo de un hercio y pulsos constantes o deslizantes, dobletes monoaurales (dos pistas en un mismo oído) y rampas de nivel.
Todos los osciladores se calculan a partir del tiempo absoluto, y la fase de un deslizamiento es la integral exacta 2π(f<sub>0</sub>u + ½ku²). Por tanto, la salida es idéntica bit a bit para cualquier tamaño de bloque, algo que comprueba una prueba unitaria. Las fases iniciales son un hash de las frecuencias del par, así que los renders son deterministas.
Ruido. Se generan tres flujos de ruido independientes y con semilla (izquierdo, derecho, común). Se les da forma espectral de una de dos maneras:
- Cadena fija: un integrador de un polo (−6 dB/octava por encima de ~40 Hz), un paso bajo de primer orden a 3 kHz y un paso alto a 25 Hz.
- Forma medida (
noise_shape, añadida durante este estudio): un FIR de fase lineal de 8191 coeficientes ajustado a un espectro objetivo, aplicado por solapamiento y suma, con su estado conservado entre bloques.
Cada fase fija lo siguiente, y los valores se mezclan a lo largo de los fundidos cruzados según las ganancias de fase:
noise_db: RMS por oído.noise_corr(c): potencia compartida. Cada oído recibe √(1−c)·propio + √c·común. Connoise_corr_below_hz, un cruce Linkwitz–Riley de cuarto orden comparte solo la banda grave y mantiene la banda aguda propia de cada oído; las dos bandas suman plano.mod_depth_dbymod_pan_deg: un ciclo sinusoidal de nivel por oído de ±profundidad dB a lo largo denoise_period_s(por defecto 10 s), con el oído derecho desplazado según el ángulo de paneo. 0° da una oleada y 90° una rotación.sweep: una copia del ruido filtrada con paso alto a 2 kHz que se suma en fase con el ciclo de cada oído, de modo que el brillo sigue al nivel.
Tabla 9. Ajustes de ruido usados en los renders de prueba.
| Volumen | noise_corr |
Compartido por debajo de | mod_depth_db |
mod_pan_deg |
sweep |
|---|---|---|---|---|---|
| I | 0,98 | 4 kHz | 0 | 0 | 0 |
| II | 0 | — | 2,5 | 0 | 0,15 |
| III–VI | 0 | — | 0,8 | 90 | 0,15 |
Masterización y autodescripción. Una única ganancia estática normaliza el máster a −24 LUFS (ITU-R BS.1770), limitada para que el pico real quede en −3 dBTP o por debajo. Después, el máster se codifica en FLAC de 24 bits y en AAC, con capítulos en los límites de fase.
Cada render escribe además una ficha técnica (describe.py). La parte de diseño enumera cada par y cada pista (pulso, banda, portadora, oído más agudo, deslizamiento, nivel), los ajustes de ruido y los clips de voz. La parte medida vuelve a analizar una ventana de 16 s sin habla en el centro de cada fase con las primitivas de §3.2. Así, el mismo código que caracterizó el conjunto de referencia comprueba cada archivo de salida.
6. Validación de la síntesis
6.1 Diseño
Renderizamos versiones de prueba de cuatro pistas de referencia, una por etapa y régimen de ruido:
- la introducción Stage A (volumen 1; ruido casi mono)
- la introducción Stage B (volumen 2; oleada)
- una introducción Stage C (volumen 5; rotación)
- una introducción Stage D (volumen 6; rotación)
Las plantillas contenían 10, 5, 25 y 24 pistas de tono. Se renderizaron a 48 kHz sin normalización, se analizaron con la herramienta sin cambios y se compararon. Los renders de prueba son material de prueba interno y no se distribuyen.
El motor se revisó durante el estudio, así que se presentan dos ejecuciones:
- Ejecución A (22:34 AEDT, 10 de octubre de 2026): la cadena de ruido fija.
- Ejecución B (22:40–22:44 AEDT): formas de ruido medidas, la división Linkwitz–Riley y
noise_corr0,98 para volumen 1.
6.2 Resultados
Tabla 10. Render de prueba frente a referencia, medidas con la misma herramienta de análisis (ejecución B; ejecución A entre corchetes cuando difiere).
| Métrica | Stage A (volumen 1) | Stage B (volumen 2) | Stage C (volumen 5) | Stage D (volumen 6) |
|---|---|---|---|---|
| Componentes sostenidos de referencia | 10 | 5 | 25 | 24 |
| Emparejados | 7 [10] | 5 [5] | 20 [14] | 23 [14] |
| Sobrantes en el render de prueba | 0 | 0 | 1 | 0 |
| Error de pulso, mediana / máx. (Hz) | 0,02 / 0,09 | 0,01 / 0,01 | 0,00 / 0,24 | 0,00 / 0,25 |
| Error de nivel, mediana / máx. |dB| | 1,1 / 6,8 [0,85 / 18,1] | 1,3 / 3,7 [0,8 / 3,9] | 1,65 / 8,6 [4,5 / 8,7] | 0,2 / 9,1 [0,15 / 2,2] |
| Error de tiempo de inicio / fin, mediana (s) | 0 / 0 | 0 / 0 | 0 / 0 | 0 / 0 |
| Pendiente del ruido, ref. → render de prueba (dB/oct) | −7,4 → −7,2 [−9,0] | −7,7 → −8,4 [−8,8] | −8,9 → −8,9 | −6,2 → −6,3 [−8,8] |
| Error de PSD por bandas de octava, 0,5–4 kHz (dB) | +3,0 a +4,2 | +0,7 a +3,8 | +2,4 a +5,0 [+10 a +14] | +0,6 a +1,7 [+11 a +13] |
| MSC 1–4 kHz, ref. → render de prueba | 0,887 → 0,74 [0,17] | 0,003 → 0,004 | 0,003 → 0,003 | 0,004 → 0,003 |
| MSC 4–10 kHz, ref. → render de prueba | 0,177 → 0,015 | 0,004 → 0,004 | 0,007 → 0,003 | 0,014 → 0,003 |
| RMS del fondo, ref. → render de prueba (dBFS) | −33,2 → −34,8 [−37,3] | −32,0 → −31,3 | −36,0 → −36,0 | −33,5 → −33,5 |
En la ejecución B se recuperaron 55 de 64 componentes sostenidos de referencia (86 %), frente a 43 de 64 (67 %) en la ejecución A. Los errores de pulso se mantuvieron dentro del bin de análisis, los errores medianos de tiempo fueron nulos y el nivel de banda ancha del fondo coincidió con un margen de 1,6 dB.
Medir la forma del ruido tuvo un gran efecto en Stage C y Stage D. En la ejecución A, la cadena fija ponía 10–14 dB de energía de más en 0,5–4 kHz, y los tonos débiles de 400–800 Hz, a entre −56 y −72 dBFS, quedaban por debajo de la prueba de prominencia de 18 dB. Ajustar el espectro recuperó la mayoría y corrigió la pendiente del ruido hasta un margen de 0,7 dB/octava.
6.3 Discrepancias pendientes
- Stage A perdió tres componentes en la ejecución B. Son 200,4/208,6 Hz (−59 dBFS), 119,5/104,8 Hz (−53 dBFS) y un par de despertar de 46 s. La estimación del ruido subió de −40,2 a −35,9 dBFS, y las octavas de 0,5–4 kHz del render de prueba están ahora 3–4 dB por encima de la referencia. Eso basta para enmascarar tonos débiles cerca del umbral de prominencia. La estimación del nivel de ruido y el margen de detección de tonos interactúan, y ninguna de las dos ejecuciones reprodujo ambos a la perfección.
- La coherencia de volumen 1 solo se reproduce en parte. El render de prueba da 0,74 en lugar de 0,89 en 1–4 kHz, y 0,015 en lugar de 0,18 en 4–10 kHz. Un cruce exactamente a 4 kHz reduce el ruido compartido hacia la parte alta de la banda inferior y lo elimina por encima. Es evidente que la referencia también comparte algo de ruido por encima de 4 kHz. Un cruce más alto, o una correlación parcial en la banda aguda, debería cerrar la diferencia.
- Trayectorias de nivel. Los errores de nivel máximos de 7–9 dB proceden de componentes de despertar cortos que suben 20–30 dB en un minuto y de componentes largos con trayectorias de nivel que suben y bajan. El replicador modela ambos con solo dos puntos (el primero y el último). El motor puede representar esas trayectorias, pero el replicador todavía no las extrae.
- Artefactos del seguimiento. Un componente "sobrante" de Stage C (594,99/599,29 Hz) y los componentes no detectados del grupo de 50 Hz se deben al intercambio de parejas entre pares solapados y muy próximos (§4.6), en el análisis de la referencia, en el del render de prueba o en ambos. No son errores de síntesis.
- Aún sin validar. El ciclo de 10 s (periodo, profundidad, fase interaural, barrido del centroide) no lo mide la herramienta de análisis. Está implementado como en la tabla 9, pero no se ha verificado frente a las referencias.
En resumen, el motor reproduce la capa de tonos (portadoras, pulsos, deslizamientos, tiempos, orientación y apilamiento) dentro de la resolución de medida. Reproduce la capa de ruido en nivel de banda ancha, pendiente espectral y, en los volúmenes posteriores, independencia interaural. Todavía no reproduce del todo la correlación limitada en banda del primer volumen ni las envolventes de nivel rápidas.
7. Discusión
7.1 Relación con las patentes
Las grabaciones aplican las ideas principales de las patentes de Monroe de una forma más sencilla y medible:
- El pulso complejo como pila. La "forma de onda de EEG replicada" aparece como una pila de unos pocos pares de senoides sobre portadoras relacionadas armónicamente (50, 100, 200–300 y 400–800 Hz), cada par pulsando en una banda convencional distinta y el pulso más lento sobre la portadora más grave.
- Gradiente de nivel. Los niveles siguen un gradiente que favorece los componentes lentos y graves, no grupos de señales discretos.
- Ruido en fase. El ruido en fase coincide con la descripción de las patentes: una rotación lenta en cuadratura entre los oídos con un barrido espectral. Su periodo es de 10 s y no de 8 s.
- Despertar. El despertar beta/gamma descrito para el procesador de sueño aparece en casi todas las pistas, a menudo con pulsos de 40 Hz.
- Sin Septon estricto. No se observó la escalera Septon, pero los grupos por debajo de un hercio y los dobletes de despertar sí combinan pulsos binaurales y monoaurales.
Hay dos diferencias principales. Primero, es el ruido, y no los tonos, lo que lleva la mayor parte de la potencia del fondo. Segundo, volumen 1 es de otra naturaleza que el resto: ruido estable casi mono, una voz guía ~10 dB por encima del fondo y portadoras que derivan. Esto es coherente con métodos de producción distintos para el material más antiguo, pero los datos no permiten establecerlo.
7.2 La base de evidencia
Este estudio mide un estímulo, no sus efectos, y la literatura experimental sobre los efectos es dispar:
- Ingendoh et al. (2023) revisaron 14 estudios de EEG. Cinco eran coherentes con el arrastre, ocho lo contradecían y uno era mixto. Los autores atribuyen buena parte de esto a la heterogeneidad de los estímulos y de los análisis.
- Orozco Perez et al. (2020) encontraron que los pulsos binaurales evocan una FFR y una ASSR cortical. Los pulsos monoaurales de control arrastraron la corteza con más fuerza, y ninguno de los dos cambió el estado de ánimo.
- Chaieb et al. (2015) revisan hallazgos contradictorios sobre cognición y estado de ánimo y subrayan la importancia de los parámetros del estímulo.
- Un metaanálisis informa de efectos sobre la ansiedad, la cognición y la percepción del dolor, moderados por la exposición y la tarea (Garcia-Argibay et al., 2019; citado a partir del resumen).
- McConnell et al. (2014; n = 21) encontraron más relajación autoinformada y cambios en la VFC durante pulsos theta después del ejercicio, en comparación con los tonos portadores solos. Las diferencias de VFC habían desaparecido al final de la sesión.
- Sudre et al. (2024) encontraron que los sonidos en paneo y los pitidos alternos afectaban al EEG y a la relajación tanto como los pulsos binaurales. Atribuyen el efecto al movimiento espacial, no al pulso.
Este último hallazgo afecta directamente a estos programas. También contienen:
- una imagen de ruido que gira lentamente
- oleadas parecidas al oleaje
- una voz guía
- largos periodos de estimulación restringida
- la expectativa que crea el planteamiento del programa
Cada uno de estos elementos podría, de forma plausible, cambiar por sí solo la activación o la relajación. Además, los tonos más prominentes son las portadoras de 50–100 Hz con pulsos de 0,5–1,5 Hz, un rango en el que, según Oster (1973), los pulsos son difíciles de separar de los propios tonos.
Por eso, los estudios sobre estos programas deberían comparar cuatro condiciones:
- portadoras dióticas equivalentes (sin pulso)
- equivalentes con pulsos monoaurales
- fondos solo de ruido y solo de voz
- ruido decorrelacionado giratorio frente a estático
El motor descrito aquí puede generar todas ellas a partir de una sola plantilla.
7.3 Uso
Para 2hives, estas medidas son objetivos de ingeniería: qué combinaciones de portadora y pulso, niveles, tratamientos del ruido y tiempos usa un programa por capas. No son especificaciones terapéuticas. Los programas de 2hives usan plantillas, guiones y voces originales. No reutilizan audio ni texto de la referencia y no usan los nombres de la fuente.
8. Limitaciones
- Detección. La detección exige una prominencia de 18 dB en una ventana de 16 s. Los tonos débiles bajo ruido fuerte o habla se pierden, y los componentes con menos de tres detecciones (~36 s) se descartan.
- Emparejamiento. El emparejamiento voraz por frecuencia más cercana con enlace de ±0,6 Hz es ambiguo en grupos densos (35,7–38,4 Hz; 49,75–50,5 Hz). Un par de 14,3 Hz entre grupos es probablemente un artefacto.
- Referencia de nivel. Los niveles son relativos a la escala completa digital. Se desconoce el nivel de presentación para quien escucha, que es el que determina la audibilidad.
- Niveles de habla y voz. El detector de habla es heurístico, y los niveles de voz incluyen el fondo que hay debajo.
- Estadísticas del ruido. Los niveles por octava son solo del oído izquierdo. La coherencia es un promedio de 16 s y no resuelve el ciclo de 10 s, cuyos parámetros proceden de medidas complementarias.
- Etiquetas de etapa. Las etiquetas de etapa proceden de los títulos y de la pertenencia a cada volumen, y el grupo Stage B es heterogéneo.
- Alcance de las pruebas. Solo se hicieron cuatro renders de prueba de fondo, mientras el motor se estaba revisando. La coherencia de volumen 1 y el ciclo de ruido aún no están validados.
- Edición. Solo se analizó una edición digital.
- Sin datos de oyentes. No se recogieron datos perceptivos ni fisiológicos.
Referencias
Atwater, F. H. (1997). Accessing anomalous states of consciousness with a binaural beat technology. Journal of Scientific Exploration, 11(3), 263–274.
Carter, G. C., Knapp, C. H., & Nuttall, A. H. (1973). Estimation of the magnitude-squared coherence function via overlapped fast Fourier transform processing. IEEE Transactions on Audio and Electroacoustics, 21(4), 337–344. https://doi.org/10.1109/TAU.1973.1162496
Chaieb, L., Wilpert, E. C., Reber, T. P., & Fell, J. (2015). Auditory beat stimulation and its effects on cognition and mood states. Frontiers in Psychiatry, 6, 70. https://doi.org/10.3389/fpsyt.2015.00070
Garcia-Argibay, M., Santed, M. A., & Reales, J. M. (2019). Efficacy of binaural auditory beats in cognition, anxiety, and pain perception: A meta-analysis. Psychological Research, 83(2), 357–372. https://doi.org/10.1007/s00426-018-1066-8
Ingendoh, R. M., Posny, E. S., & Heine, A. (2023). Binaural beats to entrain the brain? A systematic review of the effects of binaural beat stimulation on brain oscillatory activity, and the implications for psychological research and intervention. PLOS ONE, 18(5), e0286023. https://doi.org/10.1371/journal.pone.0286023
International Telecommunication Union. (2015). Algorithms to measure audio programme loudness and true-peak audio level (Recommendation ITU-R BS.1770-4).
McConnell, P. A., Froeliger, B., Garland, E. L., Ives, J. C., & Sforzo, G. A. (2014). Auditory driving of the autonomic nervous system: Listening to theta-frequency binaural beats post-exercise increases parasympathetic activation and sympathetic withdrawal. Frontiers in Psychology, 5, 1248. https://doi.org/10.3389/fpsyg.2014.01248
McDonnell, W. M. (1983). Analysis and assessment of Gateway process [Memorándum]. US Army. CIA FOIA Electronic Reading Room, CIA-RDP96-00788R001700210016-5.
Monroe, R. A. (1975). Method of inducing and maintaining various stages of sleep in the human being (U.S. Patent No. 3,884,218). U.S. Patent and Trademark Office.
Monroe, R. A. (1993). Method of inducing mental, emotional and physical states of consciousness, including specific mental activity, in human beings (U.S. Patent No. 5,213,562). U.S. Patent and Trademark Office.
Monroe, R. A. (1994). Method of and apparatus for inducing desired states of consciousness (U.S. Patent No. 5,356,368). U.S. Patent and Trademark Office.
Orozco Perez, H. D., Dumas, G., & Lehmann, A. (2020). Binaural beats through the auditory pathway: From brainstem to connectivity patterns. eNeuro, 7(2), ENEURO.0232-19.2020. https://doi.org/10.1523/ENEURO.0232-19.2020
Oster, G. (1973). Auditory beats in the brain. Scientific American, 229(4), 94–102. https://doi.org/10.1038/scientificamerican1073-94
Sudre, S., Kronland-Martinet, R., Petit, L., Rozé, J., Ystad, S., & Aramaki, M. (2024). A new perspective on binaural beats: Investigating the effects of spatially moving sounds on human mental states. PLOS ONE, 19(7), e0306427. https://doi.org/10.1371/journal.pone.0306427
Reproducibilidad. Los JSON del análisis solo contienen frecuencias, niveles y estadísticas derivados, nunca audio, de modo que el análisis puede auditarse sin las grabaciones de referencia.