Maschinell unterstützte Übersetzung
Geschichtete Binaural-Beat-Programme: Struktur in einem Referenzset gemessen und eine reproduzierbare Synthesemethode
2hives ist unabhängig und steht in keiner Verbindung zu Monroe Products oder The Monroe Institute, wird von ihnen weder unterstützt noch gebilligt. Produktnamen in dieser Notiz sind Marken ihrer Inhaber und dienen nur dazu, sachlich auf veröffentlichte Werke zu verweisen. Die Messungen beschreiben nur die akustische Struktur; es werden weder Audio noch Skript- oder Booklettexte wiedergegeben. Nichts hier ist eine gesundheitsbezogene Aussage.
2hives Forschungsnotiz · 10. Oktober 2026 · Version 1.0
Zusammenfassung
Kommerzielle Binaural-Beat-Programme werden in Marketing- oder Patentsprache beschrieben, aber ihr akustischer Aufbau wird selten gemessen. Wir haben ein kommerziell veröffentlichtes, mehrbändiges, geführtes Binaural-Programm mit einer offenen Analysemethode untersucht. Die Methode verwendet 16-s-Hann-Fenster, die alle 10 s bei 11,025 kHz weitergeschoben werden, was eine Auflösung von 0,0625 Hz ergibt. Tonspitzen müssen mindestens 18 dB über einem lokalen Median liegen und werden durch parabolische Interpolation verfeinert. Die Spitzen werden dann über die Ohren hinweg gepaart und über die Zeit verknüpft, und Rauschspektrum, interaurale Kohärenz und Sprachaktivität werden nebenbei mitgemessen.
Wir haben 620 anhaltende binaurale Komponenten (≥ 40 s) verfolgt. Die wichtigsten Ergebnisse:
- Geschichtete Klangbetten. Das Klangbett ist ein Stapel aus Sinuspaaren, in späteren Bänden typischerweise 2–3 gleichzeitig und in einem Track bis zu 13.
- Reihenfolge von Träger und Beat. Der Beat steigt mit dem Träger (Spearman ρ = 0,53): Beats unter 1 Hz liegen auf Trägern um 50 Hz, 1,5 Hz auf 100 Hz, ~4 Hz auf 200–400 Hz und 7–10 Hz auf 500–800 Hz.
- Pegelgefälle. Der Pegel einer Komponente fällt um 5,9 dB pro Oktave des Trägers.
- Dominanter Beat. 45 % der Komponenten im Hauptteil schlagen mit 3,5–4,25 Hz.
- Konstante Beats. Die Beats werden auf ±0,01 Hz/min konstant gehalten. Die Ausnahme ist der erste Band, in dem beide Träger nach unten driften.
- Rauschen. Das Rauschen fällt mit −7,5 dB/Oktave ab. Im ersten Band ist es unterhalb von 4 kHz fast mono, in den Bänden II, V und VI ist es zwischen den Ohren vollständig unabhängig und trägt dort einen 10-s-Zyklus aus Pegel und Helligkeit.
- Aufwach-Block. 35 von 36 Tracks enden mit einem lauteren Block aus Beats im Beta- und Gamma-Bereich.
Aus diesen Messungen haben wir eine Synthese-Engine nur für das Klangbett gebaut und sie getestet, indem wir Test-Renders von vier Referenz-Tracks mit demselben Werkzeug erneut vermessen haben. Mit gemessenen Rauschformen wurden 55 von 64 anhaltenden Komponenten wiedergefunden, mit medianen Beat-Fehlern ≤ 0,02 Hz und einem medianen Zeitfehler von null. Die Rauschneigung stimmte auf 0,7 dB/Oktave genau. Die bandbegrenzte interaurale Kohärenz des ersten Bandes wurde nur teilweise reproduziert (MSC 0,74 gegenüber 0,89).
Wir setzen die Ergebnisse in Beziehung zu veröffentlichten Patenten zu binauralen Audiomethoden und zur gemischten Beleglage zum Binaural-Beat-Entrainment. Es werden keine therapeutischen Aussagen gemacht.
1. Einleitung
1.1 Binaurale Beats und die Frequenzfolgeantwort
Wenn Töne leicht unterschiedlicher Frequenz, f<sub>L</sub> und f<sub>R</sub>, getrennt an die beiden Ohren gelangen, nehmen Hörende eine Schwankung bei |f<sub>R</sub> − f<sub>L</sub>| wahr. Die Wellenformen vermischen sich akustisch nie, deshalb entsteht dieser binaurale Beat zentral, höchstwahrscheinlich im oberen Olivenkomplex (Chaieb et al., 2015; Orozco Perez et al., 2020).
Oster (1973) fasste die klassische Psychophysik zusammen:
- Der Beat ist bei Trägern um 440 Hz am deutlichsten und verschwindet nahe 1.000 Hz (andere Forschende berichten bis ~1.500 Hz).
- Unterhalb von ~90 Hz wird der Beat leicht mit den Tönen selbst verwechselt.
- Er übersteht große Pegelunterschiede zwischen den Ohren.
- Er bleibt als Modulation von Maskierungsrauschen hörbar.
Ein monauraler Beat ist etwas anderes: Zwei Töne im selben Ohr mischen sich physikalisch zu einer Amplitudenmodulation.
Der auditive Hirnstamm rastet phasenstarr auf periodischen Schall ein. Das ergibt eine an der Kopfhaut ableitbare Frequenzfolgeantwort (FFR) bei den Reizfrequenzen. Bei der Beat-Frequenz kann der Kortex eine auditive Steady-State-Antwort (ASSR) zeigen. Orozco Perez et al. (2020) haben beides an denselben Teilnehmenden aufgezeichnet. Die kommerzielle Nutzung stützt sich auf eine stärkere Entrainment-Hypothese: dass ein anhaltender Beat in einem üblichen EEG-Band laufende Hirnrhythmen verschiebt und mit ihnen den mentalen Zustand. Die Belege für diese Hypothese sind uneinheitlich (§7.2).
1.2 Geschichte und Ziele
R. A. Monroe ließ zwischen 1975 und 1994 Audiomethoden zur Schlafinduktion und für „Bewusstseinszustände“ patentieren. Atwater (1997) beschrieb ein Binaural-Beat-Verfahren, und eine US-Army-Einschätzung von 1983, von der CIA freigegeben, analysierte ein Verfahren dieser Art (McDonnell, 1983).
Keine dieser Quellen nennt Träger, Beats, Pegel oder Rauschparameter für Programme, die an die Öffentlichkeit gehen. Diese Notiz hat drei Ziele:
- Das Klangbett veröffentlichter Referenzprogramme mit einer offenen, reproduzierbaren Methode messen.
- Eine Engine spezifizieren, die Klangbetten mit derselben messbaren Struktur synthetisiert.
- Die Engine validieren, indem ihre Ausgabe mit demselben Werkzeug erneut vermessen wird.
2. Frühere technische Beschreibungen
US 3,884,218 (1975) liegt zeitlich vor den binauralen Beats. Beansprucht wird ein „vertrauter, sich wiederholender, angenehmer Klang“, der mit einem schlaf-EEG-förmigen Signal amplitudenmoduliert und über dem Umgebungsgeräusch abgespielt wird. Als mögliche Klänge werden Regen, Wind, Wellen an einem Strand, Atmen und ein 500-Hz-Brummen genannt.
US 5,213,562 (1993) überlagert eine „nachgebildete EEG-Wellenform“ mit zwei Sätzen von Stereo-Trägern, sodass sie als interaurale Beat-Frequenzen erscheint. Das Ausführungsbeispiel verwendet Träger von 100 Hz und 104 Hz (ein 4-Hz-Beat). Es erlaubt „bis zu 100 separate Trägerpaare“ und nennt 275 Hz den „wirksamsten harmonischen Träger“ für 4–5 Hz.
Dasselbe Patent definiert Phased Pink Sound als „relative rotierende Verschiebung von rosa Rauschen von einem Stereokanal zum anderen mit zyklischen Änderungen von Amplitude, Frequenz und Panning-Rate“. Es behauptet, dass dies, mindestens 10 dB unter den Beat-Signalen eingesetzt, die FFR um bis zu 30 % verstärkt. Der Quellcode ist ein sinusförmig durchgefahrener Kammfilter auf Rauschen, mit Verzögerungen von 60–80 Samples und einem 8-s-Zyklus.
US 5,356,368 (1994) ergänzt vier Elemente:
- Ein Septon. Drei binaurale Beats und zwei monaurale Beats pro Ohr auf einer gemeinsamen Trägerleiter. Im Beispiel hat das linke Ohr 200, 204 und 208 Hz und das rechte Ohr 204, 208 und 212 Hz.
- Geflangtes Rauschen. Eine Kammfilter-Verzögerung, die mit „etwa 1/8 Hz“ durchgefahren wird, mit beliebiger Links-rechts-Phase des Durchlaufs.
- Gestapelte Signalgruppen. Eine 90-min-Folge von Gruppen mit festen Abständen (Gruppe B 15 dB unter A; Rauschen und Stimme 10–20 dB unter der führenden Gruppe).
- Eine Aufwach-Sequenz. Signale im Beta-Bereich oder „eine 400-Hz/416-Hz-Hüllkurve“ etwa 5 min vor dem Aufwachen. Anspruch 15 legt Theta-Alpha-Signale gefolgt von Beta-Gamma-Signalen fest.
Atwater (1997) beschreibt Binaural Beats in Kombination mit eingeschränkter Stimulation, verbaler Führung, „Pink Sound“ und Naturklängen. Er stellt fest, dass wirksame Reize „komplexe, hirnwellenartige Muster statt einfacher Sinuswellen“ sind (seine Abb. 1–2). Er zitiert Osters Trägergrenze von ~1.000 Hz und die Beobachtung, dass Rauschen den Beat verstärkt. Frequenzen oder Pegel gibt er nicht an.
McDonnell (1983) beschreibt die Frequenzen als „auf einem praktisch unterschwelligen, kaum hörbaren Pegel abgespielt“, manchmal „zusammen mit anderen Klängen wie Meeresbrandung eingeblendet“. Er berichtet, dass „rosa und weißes Rauschen“ in einer späteren Phase hinzukommt und dass spätere Phasen „zusätzliche Klangebenen“ ergänzen.
Tabelle 1 listet die Konstruktionsbehauptungen auf, die unsere Daten prüfen können.
Tabelle 1. Prüfbare Konstruktionsbehauptungen.
| # | Behauptung | Quelle |
|---|---|---|
| C1 | Tiefe Träger; Beispiel 100/104 Hz | US 5,213,562 |
| C2 | Mehrere Trägerpaare gleichzeitig („komplexer“ Beat) | US 5,213,562; Atwater 1997 |
| C3 | Signalgruppen mit festen Abständen von 10–20 dB | US 5,356,368 |
| C4 | Septon-Leiter (3 binaurale + 2 monaurale Beats pro Ohr) | US 5,356,368 |
| C5 | Zyklisches, interaural „phasenverschobenes“ Rauschen, ~8 s | US 5,213,562; 5,356,368 |
| C6 | Rauschen ≥ 10 dB unter den Beat-Signalen | US 5,213,562 |
| C7 | Brandungsähnlicher, amplitudenmodulierter Klang | US 3,884,218; McDonnell 1983 |
| C8 | Töne auf kaum hörbarem Pegel | McDonnell 1983 |
| C9 | Beta/Gamma-Aufwach-Block | US 5,356,368 |
3. Material und Methoden
3.1 Referenzmaterial
Das Referenzset ist ein kommerziell veröffentlichtes, geführtes Programm aus mehreren Bänden. Die Tracks dauern etwa 27–46 Minuten und verbinden eine gesprochene Führung mit einem durchgehenden Klangbett aus Tönen und Rauschen.
Hier werden weder Audio noch Skript- oder Booklettexte wiedergegeben.
Die Tracks wurden anhand von Titel und Band vier Stufen zugeordnet: Stufe A (5 Tracks), Stufe B (19; Bände 2–4 plus der erste Track von Band 5), Stufe C (5), Stufe D (6) und ein einführender Track, der zu Stufe A gruppiert wurde. Diese Bezeichnungen dienen nur als Gruppierungsvariablen.
3.2 Analysemethode
Das Analysewerkzeug verwendet dieselben Analysebausteine, mit denen die Engine ihre eigenen Renders prüft. Jeder Track wird zweimal mit ffmpeg zu Float-Stereo dekodiert: einmal mit 11,025 kHz für Töne und einmal mit 44,1 kHz für Rauschen und Stimme. Die Analyse nutzt 16-s-Fenster alle 10 s, etwa 215 Fenster pro Track. Tabelle 2 listet die Parameter.
Tabelle 2. Analyseparameter.
| Schritt | Regel |
|---|---|
| Tonspektrum | Eine Hann-gefensterte FFT pro Ohr und Fenster (176.400 Punkte); Bin-Abstand 0,0625 Hz; 20–1.500 Hz; amplitudenkorrigiert, sodass ein Vollaussteuerungs-Sinus 0 dBFS (Spitze) anzeigt |
| Spitzenerkennung | ≥ 18 dB über einem gleitenden Median des dB-Spektrums über 5 Hz; Spitzen ≥ 0,3 Hz auseinander; Drei-Punkt-Parabelinterpolation für Frequenzen unterhalb der Bin-Auflösung |
| Binaurales Paar | Für jeden linken Ton, der stärkste zuerst: nächster unbenutzter rechter Ton mit 0,25 ≤ |Δf| ≤ 45 Hz und Pegelunterschied ≤ 6 dB. Verworfen, wenn der rechte Ton auch im linken Ohr vorkommt (±0,25 Hz) |
| Monaural / diotisch | Töne im selben Ohr mit 0,25–45 Hz Abstand innerhalb von 10 dB; gleiche Frequenz in beiden Ohren (±0,15 Hz) |
| Komponentenverfolgung | Eine Detektion schließt sich der offenen Komponente an, deren letzte linke und rechte Frequenz innerhalb von ±0,6 Hz liegen und die innerhalb von 120 s gesehen wurde. Komponenten brauchen ≥ 3 Detektionen. Anhaltend bedeutet eine Dauer von ≥ 40 s. Der Glide ist die Kleinste-Quadrate-Steigung in Hz/min für Dauern ≥ 60 s |
| Sprache | Mittelkanal (L+R)/2, nullphasiger Bandpass 300–3.400 Hz; 50-ms-RMS-Hüllkurve. Sprache, wenn die Spanne zwischen 90. und 20. Perzentil > 14 dB beträgt (Modulation in Silbenrate) und die Mid/Side-Leistung im Band > 6 dB beträgt |
| Rauschen (sprachfreie Fenster) | Welch-PSD (8.192 Punkte) in sechs Oktaven, 250 Hz–16 kHz; Neigung angepasst über 500 Hz–16 kHz (dB/Oktave). Interaurale Magnitude-Squared-Kohärenz (MSC, 4.096 Punkte, 10,8 Hz Auflösung), gemittelt über 1–4 kHz und 4–10 kHz |
| Pegel | RMS pro Ohr. Klangbett = Median über sprachfreie Fenster; Stimme = Median über Sprachfenster |
Der Prominenztest von 18 dB ist relativ zum lokalen Grundpegel, die Erkennung hängt also vom umgebenden Rauschen ab und nicht vom absoluten Pegel. Mit etwa 340 Welch-Segmenten pro Fenster hat die MSC unabhängiger Signale eine Bias-Untergrenze von etwa 0,003 (Carter et al., 1973).
Der Analysebericht fasst die 36 Dateien zusammen. Komponenten, die mehr als 240 s vor dem Ende eines Tracks enden, bilden den Hauptteil (338 Komponenten). Komponenten, die in den letzten 300 s beginnen, bilden den Aufwach-Block. Die Beat-Bänder sind:
| Band | Bereich (Hz) |
|---|---|
| Sub-Delta | < 0,5 |
| Delta | 0,5–< 4 |
| Theta | 4–< 8 |
| Alpha | 8–< 13 |
| Beta | 13–< 30 |
| Gamma | ≥ 30 |
Der häufigste Beat, 4,0 Hz, liegt an der Grenze zwischen Delta und Theta, daher geben wir die Beats auch direkt an.
Ergänzende Messungen. Die Rauschzyklus-Parameter in §4.7 stammen aus der Hüllkurvenanalyse sprachfreier Passagen durch das 2hives-Team (10. Oktober 2026). Sie werden so wiedergegeben, wie sie übermittelt wurden.
3.3 Testverfahren der Synthese
Ein Synthesewerkzeug macht aus einer Referenzanalyse eine Vorlage nur für das Klangbett (ohne Stimme):
- Tonspuren. Jede anhaltende Komponente wird zu einer Tonspur mit denselben Start- und Endzeiten und denselben ersten und letzten linken/rechten Frequenzen, linear gegliedert. Ihr Pegel ist der erste und der letzte Wert, wenn sich diese um mehr als 3 dB unterscheiden, sonst der Median. Die Fades dauern 8 s.
- Rauschpegel. RMS des Klangbetts minus die Leistung der in der Programmmitte aktiven Töne.
- Rauschcharakter. Das Rauschspektrum wird aus der Referenz mit einem Analysewerkzeug gemessen (Welch-PSD sprachfreier Fenster, über ⅓ Oktave median-gefiltert, um Töne zu entfernen, abgetastet an ⅙-Oktav-Punkten). Interaurale Korrelation und Zyklus-Einstellungen werden pro Band festgelegt (Tabelle 9).
Vorlagen werden ohne Lautheitsnormalisierung gerendert und dann analysiert. Ein Vergleichswerkzeug ordnet jede anhaltende Referenzkomponente einer Komponente des Test-Renders zu, die sich zeitlich überschneidet und deren linke und rechte Startfrequenz innerhalb von 0,15 Hz liegen. Es meldet Beat-, Pegel- und Zeitfehler sowie die Rauschmetriken.
4. Ergebnisse
4.1 Überblick
Tabelle 3. Mediane pro Band (je sechs Tracks).
| Band | Sprachfenster | Klangbett-RMS (dBFS) | Anhaltende Komponenten / Track | Rauschneigung (dB/Okt.) | MSC 1–4 kHz | MSC 4–10 kHz |
|---|---|---|---|---|---|---|
| Band 1 | 17 % | −35,0 | 10 | −7,8 | 0,90 | 0,20 |
| Band 2 | 26 % | −31,5 | 12 | −6,1 | 0,003 | 0,004 |
| Band 3 | 10 % | −38,5 | 13,5 | −9,4 | 0,71 | 0,07 |
| Band 4 | 11 % | −41,0 | 19,5 | −7,2 | 0,48 | 0,07 |
| Band 5 | 14 % | −35,7 | 20,5 | −8,9 | 0,003 | 0,007 |
| Band 6 | 10 % | −33,6 | 19 | −6,4 | 0,004 | 0,014 |
| Alle | 14 % | −34,5 | — | −7,5 | — | — |
Wir haben 620 anhaltende Komponenten verfolgt. Ihre mediane Dauer betrug 136 s (90. Perzentil 1.146 s), und 96 dauerten mindestens 10 min.
4.2 Träger
Die Trägermitten ((f<sub>L</sub> + f<sub>R</sub>)/2) häufen sich bei runden Werten (Tabelle 4). Alle liegen bei oder unter ~1.000 Hz, der von Oster (1973) genannten Grenze, und nur 1 % liegt in ihrer Nähe. Das 100/104-Hz-Paar aus US 5,213,562 kommt genau so vor und dominiert Band 1.
Außerhalb von Band 1 kehren Frequenzen über Tracks hinweg auf 0,01 Hz genau wieder (z. B. 495,00/505,00, 99,25/100,75 und 467,00/483,00 Hz). Das spricht für eine feste Bibliothek digital erzeugter Töne.
Tabelle 4. Trägermitten anhaltender Komponenten (25-Hz-Klassen, die obersten 12 von 620).
| Mitte (Hz) | n | Mitte (Hz) | n |
|---|---|---|---|
| 500 | 78 | 200 | 35 |
| 600 | 67 | 250 | 19 |
| 100 | 65 | 475 | 19 |
| 50 | 55 | 800 | 16 |
| 400 | 52 | 275 | 15 |
| 300 | 46 | 350 | 12 |
4.3 Beats nach Stufe
Tabelle 5. Beats im Hauptteil nach Stufe (Anzahlen; Aufwach-Block ausgenommen).
| Stufe | n | Sub-δ | δ | θ | α | β | γ | Häufigste Beats, Hz (Anzahl) | Typische Paare (Hz) |
|---|---|---|---|---|---|---|---|---|---|
| Stufe A | 27 | 0 | 14 | 7 | 4 | 2 | 0 | 3,75 (11), 4,0 (5) | 100/104, 298/302 |
| Stufe B | 162 | 3 | 85 | 61 | 10 | 2 | 1 | 4,0 (42), 3,75 (25), 3,5 (23), 4,25 (14), 0,75 (8) | 50/50,5, 99/103, 401/397 |
| Stufe C | 68 | 1 | 28 | 20 | 18 | 0 | 1 | 10,0 (17), 1,5 (14), 7,25 (12), 0,75 (8), 4,0 (8) | 595/605, 495/505, 99,25/100,75 |
| Stufe D | 78 | 0 | 28 | 32 | 9 | 9 | 0 | 4,0 (22), 7,25 (11), 1,5 (10), 2,0 (8), 16,0 (6) | 248/252, 298/302, 38/36 |
| Alle | 338 | 4 | 158 | 120 | 41 | 13 | 2 | 4,0 (77), 3,75 (38), 10,0 (30), 1,5 (27), 7,25 (25) | — |
Im gesamten Hauptteil schlagen 153 von 338 Komponenten (45 %) mit 3,5–4,25 Hz. Die Stufen unterscheiden sich vor allem darin, was um diesen Kern herum geschichtet wird (Abb. 1–2):
- Stufe A: ein Klangbett mit 3,75–4 Hz auf 100-Hz- und 300-Hz-Trägern, mit kurzen Alpha- und Beta-Komponenten.
- Stufe B: ergänzt einen 50-Hz-Cluster mit Beats von 0,5–0,75 Hz.
- Stufe C: ergänzt eine Alpha-Schicht (10 Hz auf 495/505 und 595/605 Hz; 7,25 Hz auf 504/511, 607/599 und 807/800 Hz) über einem 1,5-Hz-Paar bei 99,25/100,75 Hz.
- Stufe D: kombiniert diese Schichten, ergänzt ein 2,12-Hz-Paar bei 36/38 Hz und fügt einige 16-Hz-Komponenten hinzu.
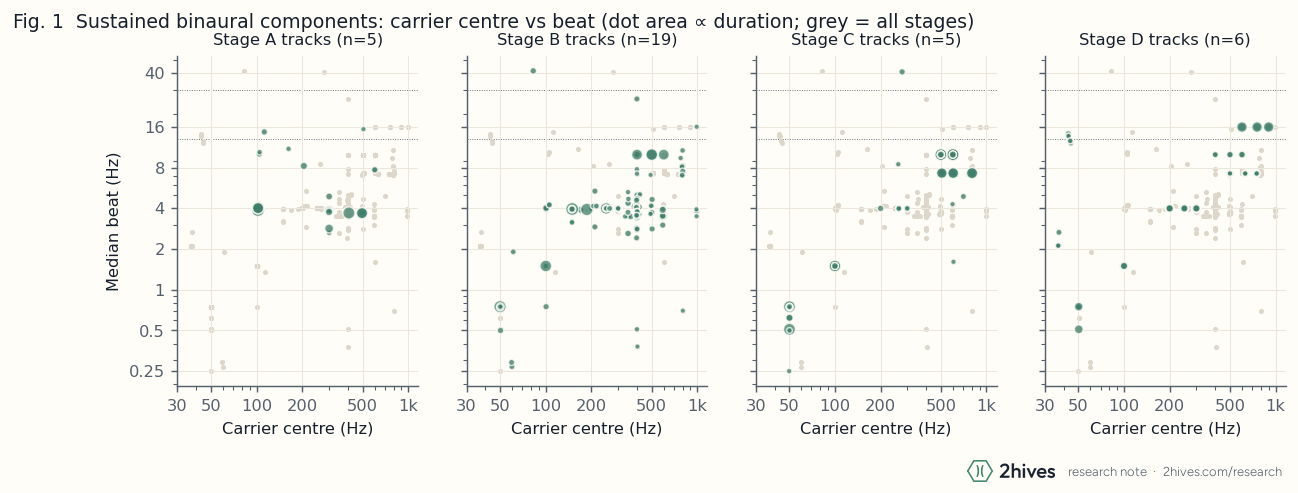
Abbildung 1. Trägermitte gegen medianen Beat der Komponenten im Hauptteil nach Stufe (blau) gegenüber allen Stufen (grau). Die Punktfläche ist proportional zur Dauer; gepunktete Linien markieren Bandgrenzen.
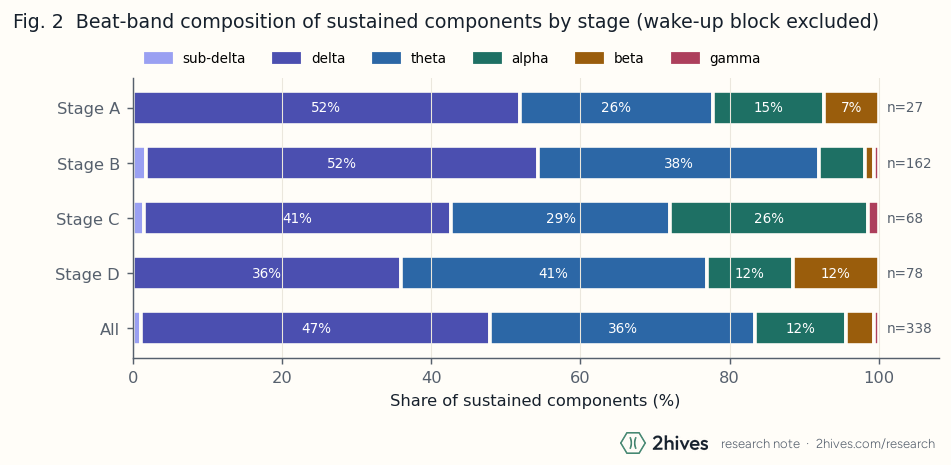
Abbildung 2. Anteile der Beat-Bänder an den Komponenten im Hauptteil nach Stufe.
4.4 Stapelung: Trägerreihenfolge, Gleichzeitigkeit und Pegel
Trägerreihenfolge. Der Beat steigt mit der Trägerfrequenz (Spearman ρ = 0,53, n = 620; Tabelle 6). Jeder Stapel legt seinen langsamsten Beat auf seinen tiefsten Träger. Zum Beispiel kombiniert der Track vom Typ Stufe D in Abb. 3:
| Träger (Hz) | Beat (Hz) |
|---|---|
| 50 | 0,5–0,75 |
| 100 | 1,5 |
| 200, 250, 300 | 4 |
| 400, 500, 600 | 10 |
Tabelle 6. Beat und Pegel nach Trägerband (620 anhaltende Komponenten).
| Träger (Hz) | n | Medianer Beat (Hz) | Beat p10–p90 (Hz) | Medianer Pegel (dBFS Spitze) |
|---|---|---|---|---|
| < 75 | 65 | 0,75 | 0,5–5,4 | −41,6 |
| 75–150 | 82 | 1,6 | 1,5–10,3 | −42,5 |
| 150–250 | 57 | 4,0 | 4,0–13,7 | −51,5 |
| 250–350 | 83 | 4,0 | 3,7–15,2 | −54,4 |
| 350–450 | 68 | 4,3 | 3,3–15,3 | −56,8 |
| 450–550 | 101 | 10,0 | 3,7–16,0 | −52,2 |
| 550–700 | 79 | 10,0 | 3,5–40,0 | −61,8 |
| 700–1.100 | 69 | 7,3 | 3,3–30,6 | −82,8 |
Gleichzeitigkeit. Wir haben die anhaltenden Komponenten im Hauptteil gezählt, die an jeder Fenstermitte aktiv sind:
| Band | Median | 90. Perz. | Max. | Anteil der Fenster mit ≥ 2 |
|---|---|---|---|---|
| Band 1 | 1 | 4 | 6 | 39 % |
| Band 2 | 1 | 2 | 3 | 12 % |
| Band 3 | 0 | 4 | 13 | 18 % |
| Band 4 | 1 | 3 | 11 | 40 % |
| Band 5 | 3 | 4 | 7 | 78 % |
| Band 6 | 2 | 5 | 8 | 59 % |
Die niedrigen Mediane in den Bänden 2–4 spiegeln zum Teil Abschnitte, in denen unter Sprache oder lautem Rauschen kein Ton den Prominenztest von 18 dB besteht. Der „komplexe binaurale Beat“ (C2) wird daher als Stapel getrennter Sinuspaare auf harmonisch verwandten Trägern umgesetzt, nicht als eine nichtsinusförmige Wellenform auf einem einzelnen Träger.
Pegel. Die Tonpegel im Hauptteil haben ein 10./50./90. Perzentil von −69,8/−53,5/−38,0 dBFS (Spitze). Der Pegel fällt um 5,9 dB pro Oktave des Trägers (n = 338; ρ = −0,69; Abb. 4), sodass die Komponenten bei 50–100 Hz vorne liegen. Innerhalb eines Fensters übertrifft das stärkste Paar das nächste im Median um 2–7 dB, je nach Band.
Dieses kontinuierliche Gefälle unterscheidet sich von den diskreten 10–20-dB-Gruppen aus C3. Der mediane Ton liegt in der Breitbandleistung etwa 16 dB unter dem RMS des Klangbetts, was relativ gesehen zu „kaum hörbar“ passt (C8). Es bedeutet aber, dass das Rauschen das Klangbett dominiert, das Gegenteil von C6.
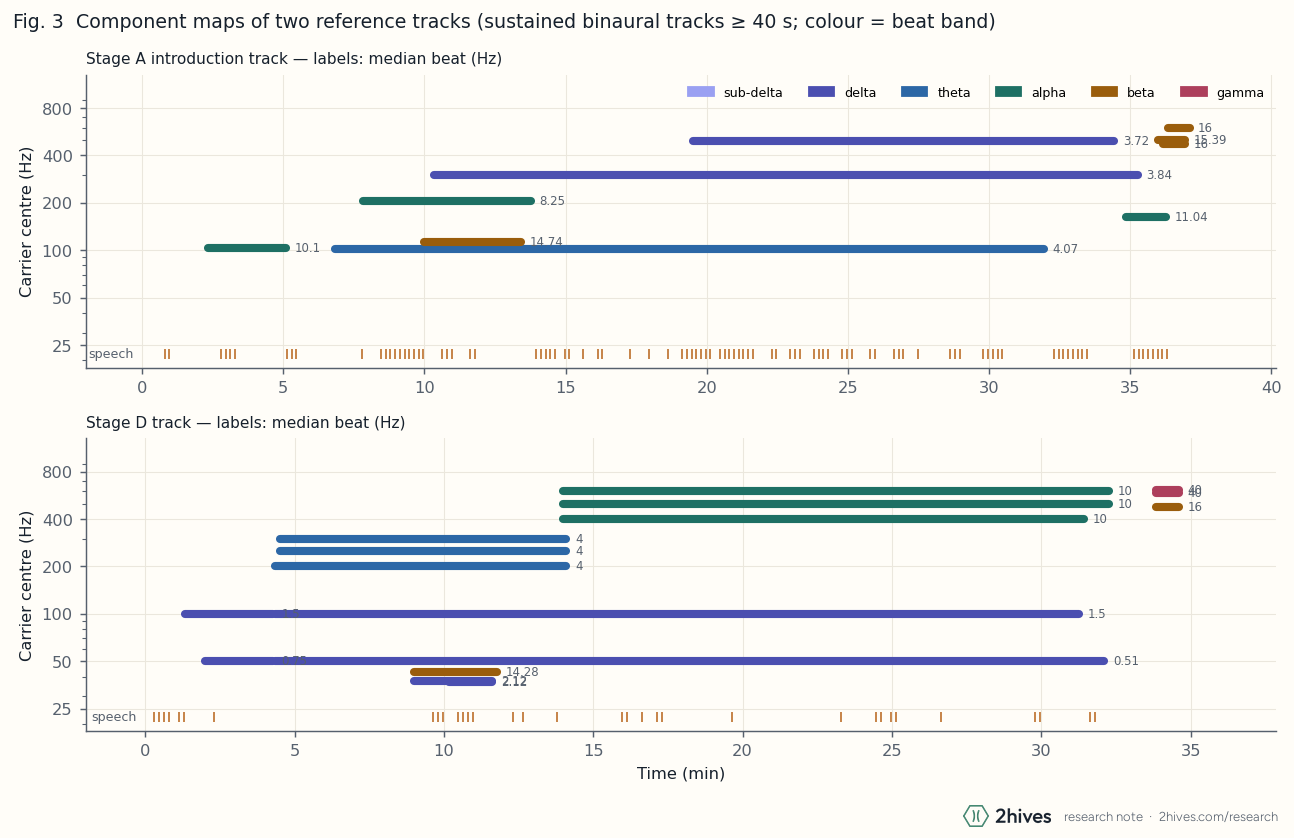
Abbildung 3. Komponentenkarten eines Tracks vom Typ Stufe A (oben) und vom Typ Stufe D (unten). Balken markieren anhaltende Komponenten an ihrer Trägermitte, nach Band eingefärbt und mit dem medianen Beat beschriftet. Striche markieren Sprachfenster.
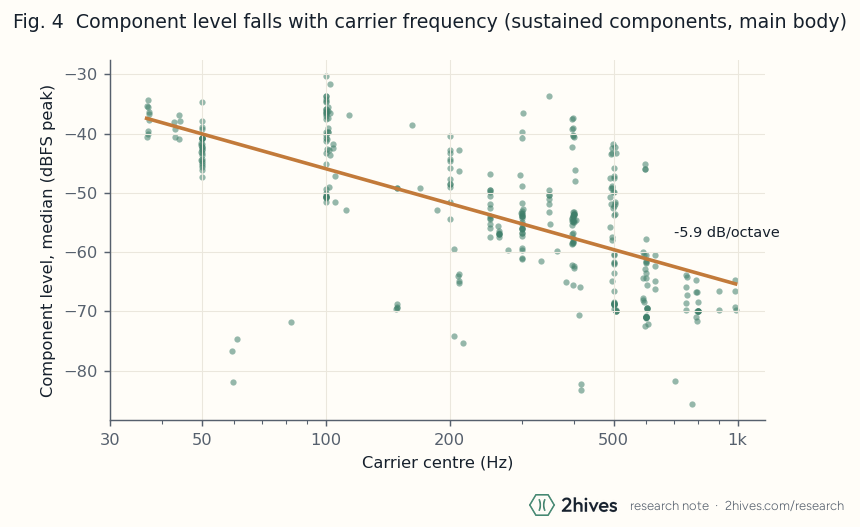
Abbildung 4. Komponentenpegel gegen Trägermitte (Hauptteil) mit einer Kleinste-Quadrate-Anpassung über der logarithmischen Frequenz.
4.5 Ohr-Orientierung und Glides
Orientierung. Der höhere Träger liegt in 356 von 620 Komponenten (57,4 %) im rechten Ohr (Binomial-p = 0,0003, was die Beleglage überzeichnet, weil die Komponenten nicht unabhängig sind). Dasselbe Paar tritt innerhalb eines Tracks oft in beiden Orientierungen auf; zum Beispiel kommen 99,25/100,75 und 100,75/99,25 Hz je 13-mal vor.
Glides. Die Beats werden fast konstant gehalten. Über die 155 Komponenten, die mindestens 5 min dauern, lauten die Perzentile des Beat-Glides:
| Perzentil | Beat-Glide (Hz/min) |
|---|---|
| 5. | −0,011 |
| 50. | 0,000 |
| 95. | +0,004 |
Band 1 ist die Ausnahme. Beide Träger seiner langen Komponenten bei 100/104 Hz und 298/302 Hz fallen um 0,01–0,04 Hz/min, und der Beat fällt um etwa 0,01 Hz/min. Beispiele sind 4,08 → 3,87 Hz über 25 min (100,27/104,35 → 99,84/103,71 Hz) und 4,10 → 3,86 Hz über 29 min. Das 2hives-Team hat unabhängig davon 4,13 → 3,89 Hz über ~25 min gemessen.
Die beiden Träger fallen um unterschiedliche Anteile (−0,43 % und −0,61 %), die Drift ist also kein Fehler der Wiedergabegeschwindigkeit. Es könnte entweder ein bewusster Sweep oder frei laufende analoge Oszillatoren sein; die Daten können das nicht unterscheiden. Die Pegelverläufe sind ähnlich flach: Die mediane Steigung beträgt −0,015 dB/min (10.–90. Perzentil −0,40 bis +0,14).
4.6 Monaurale und diotische Struktur
In 6.334 sprachfreien Fenstern wurde keine strikte Septon-Leiter (C4) gefunden. Wir haben nach einem linken Ton f, einem gemeinsamen Ton f + d und einem rechten Ton f + 2d gesucht, wobei d dem binauralen Beat entspricht. Mehrere verwandte Cluster mischen binaurale und monaurale Beats:
- 50-Hz-Cluster (Bände 2, 4–6). Das linke Ohr trägt 49,75 + 50,0 Hz und das rechte Ohr 50,0 + 50,5 Hz. Das ergibt binaurale Beats von 0,5–0,75 Hz und monaurale Beats von 0,25–0,5 Hz, mit 50,0 Hz diotisch. Der Tracker vertauscht in diesem Cluster manchmal die Partner, sodass scheinbare „Glides“ von 0,75 → 0,25 Hz hier Paarungswechsel sind, keine Sweeps.
- 36/38-Hz-Paar (Band 6). Das linke Ohr trägt 37,84 + 38,38 Hz und das rechte Ohr 35,72 + 36,26 Hz, was einen binauralen Beat von 2,12 Hz und in jedem Ohr einen monauralen Beat von 0,54 Hz ergibt.
- Aufwach-Dubletten. Das linke Ohr trägt 568 + 592 Hz und das rechte Ohr 608 + 632 Hz, was zwei binaurale 40-Hz-Beats über einem monauralen 24-Hz-Beat in jedem Ohr ergibt (§4.9).
Diotische Töne nahe 60, 120 und 180 Hz in den Bänden 1, 3 und 4 sind höchstwahrscheinlich Netzbrummen aus der Produktion, kein gestalteter Inhalt.
4.7 Rauschen: Spektrum, Kohärenz und der phasenverschobene Zyklus
Spektrum. Sprachfreies Rauschen fällt im Median mit −7,5 dB/Oktave ab (500 Hz–16 kHz). Das ist steiler als rosa (−3 dB/Oktave) und nahe an braun (−6 dB/Oktave), „Pink Sound“ in den Patenten ist also locker zu lesen. Die dekorrelierten Bände haben bei 0,5–4 kHz, bezogen auf die Oktave 250–500 Hz, 8–12 dB weniger Energie als Band 1 (Abb. 5).
Kohärenz. Die Bände fallen in drei Regime:
- Band 1: fast mono und gleichmäßig. Die MSC beträgt etwa 0,89 bei 1–4 kHz und 0,18 bei 4–10 kHz, die Ohren teilen also fast das gesamte Rauschen unterhalb von ~4 kHz.
- Bände 2, 5 und 6: unabhängig. Die MSC beträgt 0,003–0,014, die Untergrenze des Schätzers, jedes Ohr erhält also unabhängiges Rauschen.
- Bände 3 und 4: gemischt. Die Track-Mediane reichen von 0,003 bis 0,93.
Zyklus. Ab Band 2 trägt das Rauschen einen 10,0-s-Zyklus (ergänzende Messungen; Tabelle 7).
Tabelle 7. Varianten der Rauschmodulation.
| Variante | Wo | Pegelhub pro Ohr | Interaurale Phase | Spektraler Effekt |
|---|---|---|---|---|
| Gleichmäßig | Band 1 | keiner | — | keiner |
| Anschwellen | Einführung Stufe B (Band 2) | beide Ohren zusammen, bis zu ≈ 10 dB Spitze-Spitze bei 1,5–8 kHz | ≈ 0° | brandungsähnliches Aufhellen |
| Rotation | Tracks vom Typ Stufe C/Stufe D | ±0,8 dB, sinusförmig | rechtes Ohr ≈ 90° voraus | Schwerpunkt bei 1–10 kHz ±235 Hz |
Die Rotationsvariante entspricht dem Phased Pink Sound der Patente (C5): eine Quadratur-Pegelrotation zwischen den Ohren mit einem spektralen Sweep, wie ihn ein durchgefahrener Kammfilter erzeugen würde. Ihre Periode von 10,0 s ist länger als die 8 s und „etwa 1/8 Hz“ der Patente. Die Variante Anschwellen entspricht dem brandungsähnlichen modulierten Klang von US 3,884,218 und McDonnell (1983) (C7).
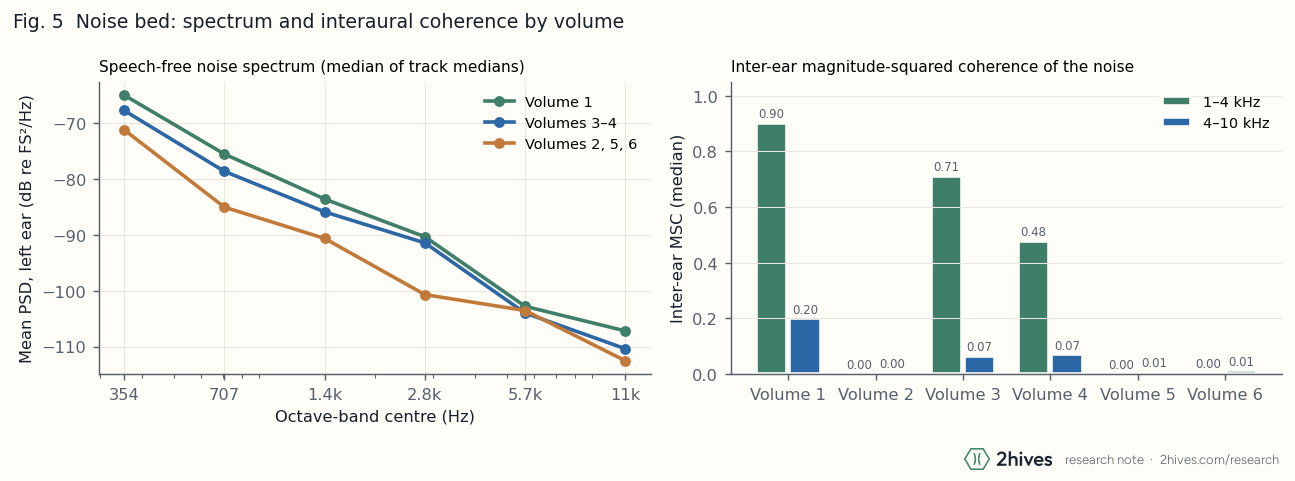
Abbildung 5. Links: Oktavband-Rausch-PSD (linkes Ohr, sprachfrei) für drei Gruppen von Bänden. Rechts: mediane interaurale MSC pro Band; ≈ 0,003 ist die Untergrenze für unabhängige Signale.
4.8 Stimme im Verhältnis zum Klangbett
Über die 31 Tracks mit Sprache sind Sprachfenster im Median 3,8 dB lauter als sprachfreie Fenster (10.–90. Perzentil 1,5–10,8 dB). Der Wert sinkt über die Reihe stetig. Der daraus abgeleitete Pegel der Stimme allein relativ zum Klangbett, den man durch Abziehen der Klangbett-Leistung erhält, sinkt mit:
| Band | Sprache − Klangbett (dB) | Abgeleitete Stimme re Klangbett (dB) |
|---|---|---|
| Band 1 | 10,1 | +9,6 |
| Band 3 | 7,0 | +6,0 |
| Band 4 | 6,1 | +4,8 |
| Band 2 | 3,4 | +0,8 |
| Band 5 | 2,8 | −0,4 |
| Band 6 | 1,5 | −4,0 |
Die Führung steht im ersten Band deutlich vor dem Klangbett und im letzten auf oder unter der Breitbandleistung des Klangbetts.
4.9 Aufwach-Signatur
In 35 von 36 Tracks beginnen in den letzten 300 s neue Komponenten, im Median 2,2 min vor dem Ende (Bereich 0,8–4,8 min). Von diesen Tracks:
- enthalten 33 Beta-Beats, meist 15–16 Hz (77 Komponenten).
- enthalten 20 Gamma-Beats.
- enthalten 19 Beats von 30–40 Hz, am häufigsten genau 40 Hz (25 Komponenten).
Die lauteste Aufwach-Komponente jedes Tracks hat einen medianen Pegel von −33,8 dBFS (10.–90. Perzentil −45,7 bis −24,0), über dem 90. Perzentil des Hauptteils von −38,0 dBFS. Diese Komponenten können in weniger als einer Minute um etwa 20 dB ansteigen.
Typische Stapel enthalten 467/483 Hz (16 Hz) mit 568/608 und 592/632 Hz (40 Hz) sowie oktavverdoppelte Paare wie 491,6/506,9 Hz (15,3 Hz) mit 983,2/1.013,7 Hz (30,5 Hz). Die Reihenfolge Theta/Alpha, dann Beta/Gamma aus Anspruch 15 von US 5,356,368 erscheint in mehreren Tracks (C9).
4.10 Frühere Behauptungen gegenüber den Messungen
Tabelle 8. Status der Behauptungen aus Tabelle 1.
| # | Behauptung | Befund |
|---|---|---|
| C1 | Tiefe Träger; 100/104 Hz | Gestützt: 100/104 Hz dominiert in Band 1; alle Träger ≤ ~1 kHz |
| C2 | Mehrere Paare gleichzeitig | Gestützt: Median 2–3 in späteren Bänden, bis zu 13; nach Trägern geordnete Stapel |
| C3 | Feste Gruppenabstände von 10–20 dB | Nicht wie angegeben: kontinuierliches Gefälle von −5,9 dB/Oktave |
| C4 | Septon-Leiter | Nicht gefunden: verwandte binaurale + monaurale Cluster existieren |
| C5 | Phasenverschobenes Rauschen, ~8 s | In der Form gestützt: 10,0-s-Quadraturrotation mit spektralem Sweep |
| C6 | Rauschen ≥ 10 dB unter den Tönen | Umgekehrt: Rauschen dominiert die Leistung des Klangbetts |
| C7 | Brandungsähnliche Modulation | Gestützt: ~10 dB gleichphasiges Anschwellen in der Einführung Stufe B |
| C8 | Kaum hörbare Töne | Stimmig (relativ): medianer Ton ≈ 16 dB unter dem RMS des Klangbetts |
| C9 | Beta/Gamma-Aufwachen | Gestützt: 35/36 Tracks, lauter als der Hauptteil |
5. Synthesemethode
Die 2hives-Engine rendert ein Programm aus einer JSON-Vorlage und einem Skript. Die Stimme wird getrennt synthetisiert und mit −22 dBFS RMS bei aktiver Sprache dazugemischt. Hier wird nur das Klangbett beschrieben.
Zeitleiste. Eine Vorlage ist eine Liste von Phasen. Jede Phase hat entweder eine feste Länge (Intro, Rückkehr) oder ist gewichtet und teilt sich die verbleibende Zeit, sodass sich ein Programm dehnt, ohne seine festen Abschnitte zu verschieben. Skriptzeilen behalten in festen Phasen ihren Versatz und in dehnbaren Phasen ihre relative Position.
Benachbarte Phasen werden durch komplementäre Raised-Cosine-Überblendungen verbunden, deren Gains sich zu 1 summieren, und das Programm hat an jedem Ende 8-s-Fades. Ein Paar, das von benachbarten Phasen geteilt wird, ist ein einzelner Oszillator und läuft daher ohne Phasen-Reset durch die Grenze.
Töne. Zwei Formen decken alles ab, was in §4 gemessen wurde:
- Phasenpaare: Tripel (f<sub>L</sub>, f<sub>R</sub>, Pegel), die an Phasen gebunden sind.
- Spuren: Paare mit eigenen Start- und Endzeiten, linearen Frequenz-Glides, in dB linearen Pegelrampen und Raised-Cosine-Fades.
Zusammen decken diese Stapel auf beliebigen Trägern ab, beide Ohr-Orientierungen, Sub-Hertz-Beats sowie konstante oder gleitende Beats, monaurale Dubletten (zwei Spuren in einem Ohr) und Pegelrampen.
Alle Oszillatoren werden aus der absoluten Zeit berechnet, und die Phase eines Glides ist das exakte Integral 2π(f<sub>0</sub>u + ½ku²). Die Ausgabe ist deshalb bei jeder Chunk-Größe bitidentisch, was ein Unit-Test prüft. Startphasen sind ein Hash der Frequenzen des Paares, sodass Renders deterministisch sind.
Rauschen. Es werden drei unabhängige, mit Seed erzeugte Rauschströme generiert (links, rechts, gemeinsam). Sie werden auf zwei Arten spektral geformt:
- Feste Kette: ein Ein-Pol-Integrator (−6 dB/Oktave oberhalb von ~40 Hz), ein Tiefpass erster Ordnung bei 3 kHz und ein Hochpass bei 25 Hz.
- Gemessene Form (
noise_shape, während dieser Studie ergänzt): ein linearphasiger FIR mit 8.191 Taps, angepasst an ein Zielspektrum und per Overlap-Add angewendet, mit über die Chunks hinweg übertragenem Zustand.
Jede Phase legt Folgendes fest, und die Werte werden über Überblendungen mit den Gains der Phasen gemischt:
noise_db: RMS pro Ohr.noise_corr(c): geteilte Leistung. Jedes Ohr erhält √(1−c)·eigenes + √c·gemeinsames. Mitnoise_corr_below_hzteilt eine Linkwitz-Riley-Weiche 4. Ordnung nur das tiefe Band und lässt jedem Ohr sein eigenes hohes Band; die beiden Bänder summieren sich flach.mod_depth_dbundmod_pan_deg: ein sinusförmiger Pegelzyklus pro Ohr von ±Tiefe dB übernoise_period_s(Standard 10 s), wobei das rechte Ohr um den Pan-Winkel versetzt ist. 0° ergibt ein Anschwellen, 90° eine Rotation.sweep: eine mit 2 kHz hochpassgefilterte Kopie des Rauschens, die phasengleich mit dem Zyklus jedes Ohrs addiert wird, sodass die Helligkeit dem Pegel folgt.
Tabelle 9. Rauscheinstellungen für die Test-Renders.
| Band | noise_corr |
Geteilt unterhalb | mod_depth_db |
mod_pan_deg |
sweep |
|---|---|---|---|---|---|
| I | 0,98 | 4 kHz | 0 | 0 | 0 |
| II | 0 | — | 2,5 | 0 | 0,15 |
| III–VI | 0 | — | 0,8 | 90 | 0,15 |
Mastering und Selbstbeschreibung. Ein statischer Gain normalisiert den Master auf −24 LUFS (ITU-R BS.1770), begrenzt, sodass der True Peak bei oder unter −3 dBTP bleibt. Der Master wird dann zu 24-Bit-FLAC und AAC kodiert, mit Kapiteln an den Phasengrenzen.
Jeder Render schreibt außerdem ein Datenblatt (describe.py). Der Entwurfsteil listet jedes Paar und jede Spur auf (Beat, Band, Träger, höheres Ohr, Glide, Pegel), dazu die Rauscheinstellungen und die Stimmclips. Der Messteil analysiert in der Mitte jeder Phase ein sprachfreies 16-s-Fenster erneut mit den Bausteinen aus §3.2. Der Code, der das Referenzset charakterisiert hat, prüft daher jede Ausgabedatei.
6. Validierung der Synthese
6.1 Aufbau
Wir haben Testversionen von vier Referenz-Tracks gerendert, je eine pro Stufe und Rauschregime:
- die Einführung von Stufe A (Band 1; fast monaurales Rauschen)
- die Einführung von Stufe B (Band 2; Anschwellen)
- eine Einführung von Stufe C (Band 5; Rotation)
- eine Einführung von Stufe D (Band 6; Rotation)
Die Vorlagen enthielten 10, 5, 25 und 24 Tonspuren. Sie wurden mit 48 kHz ohne Normalisierung gerendert, mit dem unveränderten Werkzeug analysiert und verglichen. Test-Renders sind internes Testmaterial und werden nicht verteilt.
Die Engine wurde während der Studie überarbeitet, daher werden zwei Läufe berichtet:
- Lauf A (22:34 AEDT, 10. Oktober 2026): die feste Rauschkette.
- Lauf B (22:40–22:44 AEDT): gemessene Rauschformen, die Linkwitz-Riley-Weiche und
noise_corr0,98 für Band 1.
6.2 Ergebnisse
Tabelle 10. Test-Render gegenüber Referenz, mit demselben Analysewerkzeug gemessen (Lauf B; Lauf A in Klammern, wo abweichend).
| Metrik | Stufe A (Band 1) | Stufe B (Band 2) | Stufe C (Band 5) | Stufe D (Band 6) |
|---|---|---|---|---|
| Anhaltende Referenzkomponenten | 10 | 5 | 25 | 24 |
| Zugeordnet | 7 [10] | 5 [5] | 20 [14] | 23 [14] |
| Zusätzlich im Test-Render | 0 | 0 | 1 | 0 |
| Beat-Fehler, Median / Max. (Hz) | 0,02 / 0,09 | 0,01 / 0,01 | 0,00 / 0,24 | 0,00 / 0,25 |
| Pegelfehler, Median / Max. |dB| | 1,1 / 6,8 [0,85 / 18,1] | 1,3 / 3,7 [0,8 / 3,9] | 1,65 / 8,6 [4,5 / 8,7] | 0,2 / 9,1 [0,15 / 2,2] |
| Zeitfehler Start / Ende, Median (s) | 0 / 0 | 0 / 0 | 0 / 0 | 0 / 0 |
| Rauschneigung, Referenz → Test-Render (dB/Okt.) | −7,4 → −7,2 [−9,0] | −7,7 → −8,4 [−8,8] | −8,9 → −8,9 | −6,2 → −6,3 [−8,8] |
| Oktavband-PSD-Fehler, 0,5–4 kHz (dB) | +3,0 bis +4,2 | +0,7 bis +3,8 | +2,4 bis +5,0 [+10 bis +14] | +0,6 bis +1,7 [+11 bis +13] |
| MSC 1–4 kHz, Referenz → Test-Render | 0,887 → 0,74 [0,17] | 0,003 → 0,004 | 0,003 → 0,003 | 0,004 → 0,003 |
| MSC 4–10 kHz, Referenz → Test-Render | 0,177 → 0,015 | 0,004 → 0,004 | 0,007 → 0,003 | 0,014 → 0,003 |
| Klangbett-RMS, Referenz → Test-Render (dBFS) | −33,2 → −34,8 [−37,3] | −32,0 → −31,3 | −36,0 → −36,0 | −33,5 → −33,5 |
In Lauf B wurden 55 von 64 anhaltenden Referenzkomponenten wiedergefunden (86 %), gegenüber 43 von 64 (67 %) in Lauf A. Die Beat-Fehler blieben innerhalb des Analyse-Bins, die medianen Zeitfehler waren null, und der Breitband-Pegel des Klangbetts stimmte auf 1,6 dB genau.
Das Messen der Rauschform hatte bei Stufe C und Stufe D einen großen Effekt. In Lauf A brachte die feste Kette 10–14 dB zu viel Energie in 0,5–4 kHz, und schwache 400–800-Hz-Töne bei −56 bis −72 dBFS fielen unter den Prominenztest von 18 dB. Das Anpassen des Spektrums stellte die meisten von ihnen wieder her und korrigierte die Rauschneigung auf 0,7 dB/Oktave genau.
6.3 Verbleibende Abweichungen
- Stufe A verlor in Lauf B drei Komponenten. Das sind 200,4/208,6 Hz (−59 dBFS), 119,5/104,8 Hz (−53 dBFS) und ein 46 s langes Aufwach-Paar. Die Rauschschätzung stieg von −40,2 auf −35,9 dBFS, und die Oktaven des Test-Renders bei 0,5–4 kHz liegen jetzt 3–4 dB über der Referenz. Das reicht, um schwache Töne nahe der Prominenzschwelle zu maskieren. Die Schätzung des Rauschpegels und die Marge der Tonerkennung beeinflussen sich gegenseitig, und kein Lauf hat beides perfekt reproduziert.
- Die Kohärenz von Band 1 wird nur teilweise reproduziert. Der Test-Render ergibt 0,74 statt 0,89 bei 1–4 kHz und 0,015 statt 0,18 bei 4–10 kHz. Eine Weiche bei genau 4 kHz senkt das Teilen zum oberen Ende des tiefen Bandes hin und entfernt es darüber. Die Referenz teilt offenbar auch oberhalb von 4 kHz einen Teil des Rauschens. Eine höhere Weiche oder eine teilweise Korrelation im hohen Band sollte die Lücke schließen.
- Pegelverläufe. Die maximalen Pegelfehler von 7–9 dB stammen von kurzen Aufwach-Komponenten, die innerhalb einer Minute um 20–30 dB ansteigen, und von langen Komponenten mit auf- und absteigenden Pegelverläufen. Das Test-Render-Werkzeug bildet beide nur mit zwei Punkten ab (erster und letzter). Die Engine kann solche Verläufe darstellen, aber das Test-Render-Werkzeug extrahiert sie noch nicht.
- Tracker-Artefakte. Eine „zusätzliche“ Komponente in Stufe C (594,99/599,29 Hz) und die verpassten Komponenten des 50-Hz-Clusters entstehen durch Partnertausch zwischen sich überlappenden, dicht benachbarten Paaren (§4.6), in der Analyse der Referenz, der Analyse des Test-Renders oder in beiden. Es sind keine Synthesefehler.
- Noch nicht validiert. Der 10-s-Zyklus (Periode, Tiefe, interaurale Phase, Schwerpunkt-Sweep) wird vom Analysewerkzeug nicht gemessen. Er ist wie in Tabelle 9 umgesetzt, wurde aber nicht gegen die Referenzen verifiziert.
Zusammengefasst reproduziert die Engine die Tonebene (Träger, Beats, Glides, Timing, Orientierung und Stapelung) innerhalb der Messauflösung. Die Rauschebene reproduziert sie in Breitbandpegel, spektraler Neigung und, für die späteren Bände, interauraler Unabhängigkeit. Die bandbegrenzte Korrelation des ersten Bandes und schnelle Pegelhüllkurven reproduziert sie noch nicht vollständig.
7. Diskussion
7.1 Bezug zu den Patenten
Die gemessene Struktur zeigt in einfacherer Form die Hauptideen, die die veröffentlichten Patente beschreiben:
- Komplexer Beat als Stapel. Die „nachgebildete EEG-Wellenform“ erscheint als Stapel weniger Sinuspaare auf harmonisch verwandten Trägern (50, 100, 200–300 und 400–800 Hz), wobei jedes Paar in einem anderen üblichen Band schlägt und der langsamste Beat auf dem tiefsten Träger liegt.
- Pegelgefälle. Die Pegel folgen einem Gefälle, das die langsamen, tiefen Komponenten begünstigt, nicht diskreten Signalgruppen.
- Phasenverschobenes Rauschen. Das phasenverschobene Rauschen entspricht der Beschreibung der Patente: eine langsame Quadraturrotation zwischen den Ohren mit einem spektralen Sweep. Seine Periode beträgt 10 s statt 8 s.
- Aufwachen. Das für den Schlafprozessor beschriebene Beta/Gamma-Aufwachen erscheint in fast jedem Track, oft mit 40-Hz-Beats.
- Kein striktes Septon. Die Septon-Leiter wurde nicht beobachtet, aber Sub-Hertz-Cluster und Aufwach-Dubletten kombinieren binaurale und monaurale Beats.
Es gibt zwei wesentliche Abweichungen. Erstens trägt das Rauschen, nicht die Töne, den Großteil der Leistung des Klangbetts. Zweitens unterscheidet sich Band 1 grundlegend vom Rest: fast monaurales gleichmäßiges Rauschen, eine führende Stimme ~10 dB über dem Klangbett und driftende Träger. Das ist vereinbar mit anderen Produktionsmethoden für das früheste Material, aber die Daten können das nicht belegen.
7.2 Die Beleglage
Diese Studie misst einen Reiz, nicht seine Wirkungen, und die experimentelle Literatur zu den Wirkungen ist gemischt:
- Ingendoh et al. (2023) werteten 14 EEG-Studien aus. Fünf stimmten mit Entrainment überein, acht widersprachen ihm und eine war gemischt. Die Autorinnen und Autoren führen vieles davon auf heterogene Reize und Analysen zurück.
- Orozco Perez et al. (2020) fanden, dass binaurale Beats eine FFR und eine kortikale ASSR hervorrufen. Monaurale Kontroll-Beats lösten im Kortex ein stärkeres Entrainment aus, und keiner von beiden veränderte die Stimmung.
- Chaieb et al. (2015) besprechen widersprüchliche Befunde zu Kognition und Stimmung und betonen die Bedeutung der Reizparameter.
- Eine Metaanalyse berichtet Effekte auf Ängstlichkeit, Kognition und die Wahrnehmung von Beschwerden, moderiert durch Dauer der Exposition und Aufgabe (Garcia-Argibay et al., 2019; aus dem Abstract zitiert).
- McConnell et al. (2014; n = 21) fanden nach körperlicher Belastung bei Theta-Beats mehr selbstberichtete Entspannung und HRV-Veränderungen als bei Trägertönen allein. Die HRV-Unterschiede waren am Ende der Sitzung verschwunden.
- Sudre et al. (2024) fanden, dass Panning-Klänge und alternierende Pieptöne EEG und Entspannung ebenso beeinflussten wie binaurale Beats. Sie führen den Effekt auf die räumliche Bewegung zurück, nicht auf das Schlagen.
Der letzte Befund betrifft diese Programme unmittelbar. Sie enthalten außerdem:
- ein langsam rotierendes Rauschbild
- brandungsähnliches Anschwellen
- eine führende Stimme
- lange Phasen eingeschränkter Stimulation
- Erwartungen, die durch die Rahmung des Programms entstehen
Jedes davon könnte für sich genommen plausibel Erregung oder Entspannung verändern. Zudem sind die auffälligsten Töne die 50–100-Hz-Träger mit Beats von 0,5–1,5 Hz, ein Bereich, in dem sich Beats laut Oster (1973) schwer von den Tönen selbst trennen lassen.
Studien zu solchen Programmen sollten daher vier Bedingungen vergleichen:
- abgestimmte diotische Träger (ohne Beat)
- monaurale Beat-Entsprechungen
- Klangbetten nur mit Rauschen und nur mit Stimme
- rotierendes gegenüber statischem dekorreliertem Rauschen
Die hier beschriebene Engine kann all diese aus einer einzigen Vorlage erzeugen.
7.3 Verwendung
Für 2hives sind diese Messungen technische Zielgrößen: welche Kombinationen aus Trägern und Beats, welche Pegel, Rauschbehandlungen und Zeitverläufe ein geschichtetes Programm verwendet. Sie sind keine therapeutischen Spezifikationen. 2hives-Programme verwenden eigene Vorlagen, Skripte und Stimmen. Sie übernehmen weder Referenz-Audio noch Referenztexte und verwenden nicht die Namen der Quelle.
8. Einschränkungen
- Erkennung. Die Erkennung verlangt 18 dB Prominenz in einem 16-s-Fenster. Schwache Töne unter lautem Rauschen oder Sprache werden verpasst, und Komponenten mit weniger als drei Detektionen (~36 s) werden verworfen.
- Paarung. Die gierige Paarung nach nächster Frequenz mit ±0,6-Hz-Verknüpfung ist in dichten Clustern mehrdeutig (35,7–38,4 Hz; 49,75–50,5 Hz). Ein 14,3-Hz-Paar zwischen Clustern ist wahrscheinlich ein Artefakt.
- Pegelbezug. Pegel beziehen sich auf digitale Vollaussteuerung. Der Wiedergabepegel der Hörenden, der die Hörbarkeit bestimmt, ist unbekannt.
- Sprach- und Stimmpegel. Der Sprachdetektor ist heuristisch, und die Stimmpegel enthalten das darunterliegende Klangbett.
- Rauschstatistik. Oktavpegel stammen nur vom linken Ohr. Die Kohärenz ist ein 16-s-Mittel und löst den 10-s-Zyklus nicht auf, dessen Parameter aus ergänzenden Messungen stammen.
- Stufenbezeichnungen. Die Stufenbezeichnungen stammen aus Titeln und Bandzugehörigkeit, und die Gruppe Stufe B ist heterogen.
- Umfang der Test-Renders. Es wurden nur vier Test-Renders nur des Klangbetts erstellt, während die Engine überarbeitet wurde. Die Kohärenz von Band 1 und der Rauschzyklus sind noch nicht validiert.
- Ausgabe. Es wurde nur eine digitale Ausgabe analysiert.
- Keine Daten von Hörenden. Es wurden keine wahrnehmungsbezogenen oder physiologischen Daten erhoben.
Literatur
Atwater, F. H. (1997). Accessing anomalous states of consciousness with a binaural beat technology. Journal of Scientific Exploration, 11(3), 263–274.
Carter, G. C., Knapp, C. H., & Nuttall, A. H. (1973). Estimation of the magnitude-squared coherence function via overlapped fast Fourier transform processing. IEEE Transactions on Audio and Electroacoustics, 21(4), 337–344. https://doi.org/10.1109/TAU.1973.1162496
Chaieb, L., Wilpert, E. C., Reber, T. P., & Fell, J. (2015). Auditory beat stimulation and its effects on cognition and mood states. Frontiers in Psychiatry, 6, 70. https://doi.org/10.3389/fpsyt.2015.00070
Garcia-Argibay, M., Santed, M. A., & Reales, J. M. (2019). Efficacy of binaural auditory beats in cognition, anxiety, and pain perception: A meta-analysis. Psychological Research, 83(2), 357–372. https://doi.org/10.1007/s00426-018-1066-8
Ingendoh, R. M., Posny, E. S., & Heine, A. (2023). Binaural beats to entrain the brain? A systematic review of the effects of binaural beat stimulation on brain oscillatory activity, and the implications for psychological research and intervention. PLOS ONE, 18(5), e0286023. https://doi.org/10.1371/journal.pone.0286023
International Telecommunication Union. (2015). Algorithms to measure audio programme loudness and true-peak audio level (Recommendation ITU-R BS.1770-4).
McConnell, P. A., Froeliger, B., Garland, E. L., Ives, J. C., & Sforzo, G. A. (2014). Auditory driving of the autonomic nervous system: Listening to theta-frequency binaural beats post-exercise increases parasympathetic activation and sympathetic withdrawal. Frontiers in Psychology, 5, 1248. https://doi.org/10.3389/fpsyg.2014.01248
McDonnell, W. M. (1983). Analysis and assessment of Gateway process [Memorandum]. US Army. CIA FOIA Electronic Reading Room, CIA-RDP96-00788R001700210016-5.
Monroe, R. A. (1975). Method of inducing and maintaining various stages of sleep in the human being (U.S. Patent No. 3,884,218). U.S. Patent and Trademark Office.
Monroe, R. A. (1993). Method of inducing mental, emotional and physical states of consciousness, including specific mental activity, in human beings (U.S. Patent No. 5,213,562). U.S. Patent and Trademark Office.
Monroe, R. A. (1994). Method of and apparatus for inducing desired states of consciousness (U.S. Patent No. 5,356,368). U.S. Patent and Trademark Office.
Orozco Perez, H. D., Dumas, G., & Lehmann, A. (2020). Binaural beats through the auditory pathway: From brainstem to connectivity patterns. eNeuro, 7(2), ENEURO.0232-19.2020. https://doi.org/10.1523/ENEURO.0232-19.2020
Oster, G. (1973). Auditory beats in the brain. Scientific American, 229(4), 94–102. https://doi.org/10.1038/scientificamerican1073-94
Sudre, S., Kronland-Martinet, R., Petit, L., Rozé, J., Ystad, S., & Aramaki, M. (2024). A new perspective on binaural beats: Investigating the effects of spatially moving sounds on human mental states. PLOS ONE, 19(7), e0306427. https://doi.org/10.1371/journal.pone.0306427
Reproduzierbarkeit. Die JSON-Dateien der Analyse enthalten nur abgeleitete Frequenzen, Pegel und Statistiken, niemals Audio, sodass die Analyse ohne das Referenzmaterial geprüft werden kann.